

💡 核心摘要
- 目前 Codex 降智现象主要普遍存在于 20 倍 Pro 订阅上,部分 Plus 和 5 倍 Pro 订阅暂未受到显著影响。
- 文章总结了 5 种行之有效的 GPT 降智检测方法,包括 SVG 动画生成、概率论逻辑题测试、知识截止日期探测等。
- 当遇到模型降智时,建议开启 5.6 模型的 Fast 模式以提升交互效率,或将长任务切换至 Claude、Grok、Gemini 等其他大模型。
- 提前判断和分析模型状态可避免额度浪费,提早做好切换模型或检查内容的准备,防止工作白费。
一、为什么高阶用户需要及时进行 GPT 降智检测?
在当前的 AI 使用场景中,许多重度用户和开发者发现模型输出质量有时会出现断崖式下跌,这种现象在业界通常被称为“降智”。根据目前的观察与经验反馈,此类降智现象主要集中在 20 倍 Pro 订阅上,而大部分 Plus 和 5 倍 Pro 订阅用户受到的影响相对较小。面对模型能力的隐性阉割,盲目继续使用不仅会消耗宝贵的 API 额度或订阅配额,还可能导致输出结果无法达到预期。因此,掌握科学的 GPT 降智检测方法,提前判断并分析自己的模型是否发生降质,是每一位高阶 AI 用户避免损失、优化工作流的关键前提。
二、如何通过代码生成与推理题识别模型深度降智?
为了精准探测 Codex 或 GPT 是否被降智,可以通过特定的高难度指令来测试其代码生成能力与深度推理能力。这些测试能够直接暴露出模型底层算力或对齐策略的变动。
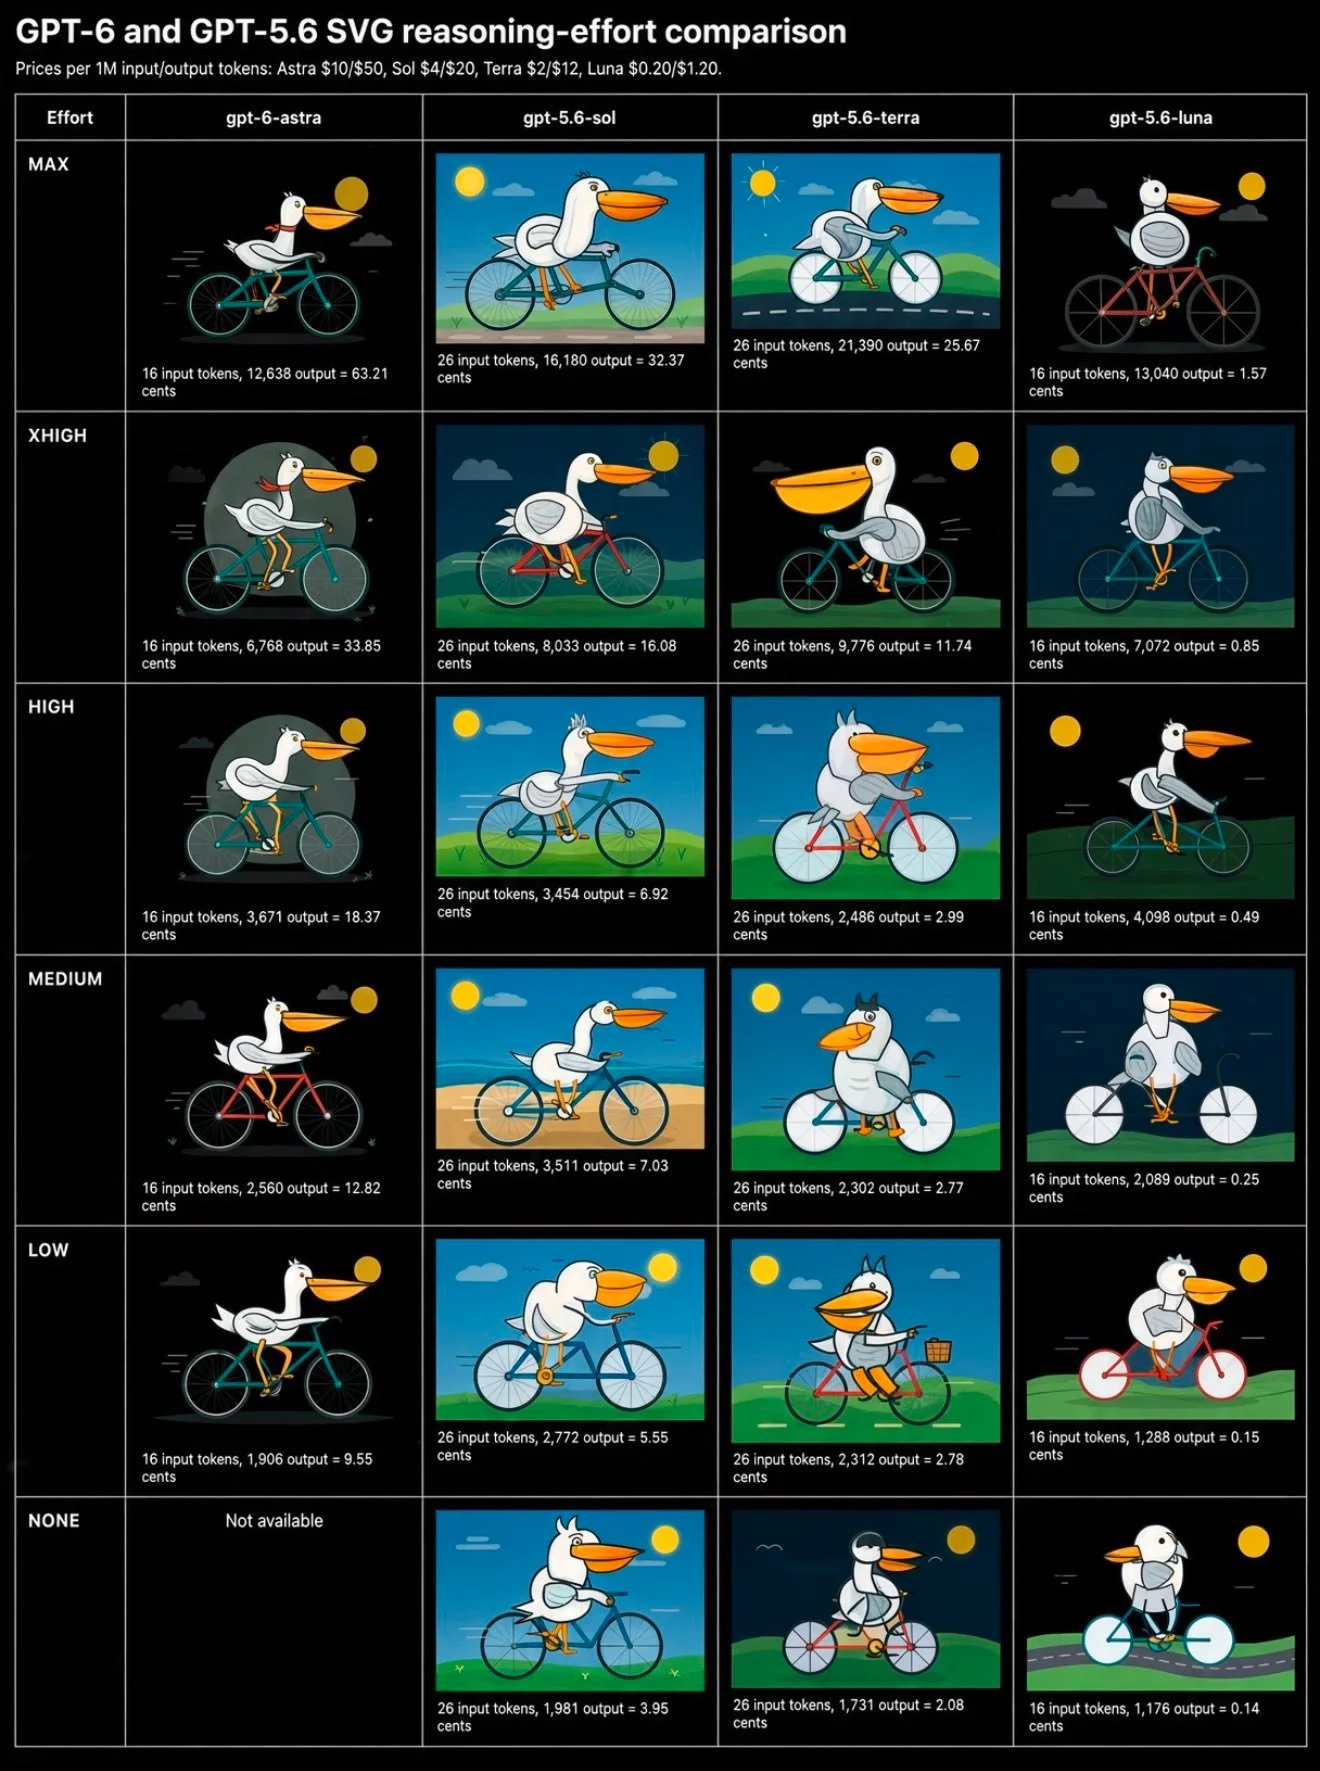
1. SVG 动画生成测试(验证基础代码与绘图逻辑的失真度)
在 Codex APP 的全新对话中发送指令:“创建一个 HTML,内容是 SVG 绘制一个鹈鹕骑自行车的 2D 动画”。未降智的模型通常能够迅速且完整地渲染出符合要求的矢量图形与动画代码,而降智后的模型往往会输出错误、残缺或者无法运行的代码。
2. 概率论逻辑题探测(检测深度推理能力是否被阉割)
不使用任何外部工具,直接让模型回答以下糖果概率组合问题:“在一个黑色的袋子里放有三种口味的糖果,每种糖果有两种不同的形状(圆形和五角星形……)”。由于该题目涉及复杂的组合逻辑和边界条件统计(苹果味、桃子味、西瓜味在不同形状下的数量统计),深度推理被阉割的降智模型往往无法给出正确的数学推导过程。
三、如何通过元数据与知识库快照探测判断降智状态?
除了功能性测试,利用系统内置的元数据(如知识截止日期与工具可用性)也能为降智检测提供客观、可量化的判断依据。
1. 知识截止日期查询(探测系统时间元数据的倒退现象)
要求模型不加推测、直接输出其系统设定的 Knowledge Cutoff(知识截止日期)以及当前认定的基准时间元数据。未降智的模型会返回与当前订阅批次匹配的最晚日期(如对应批次的 2025/2026 年切片);而异常(已降智)的模型则会出现明显的日期倒退,例如回退至更早期的 2023 或 2024 年初快照。
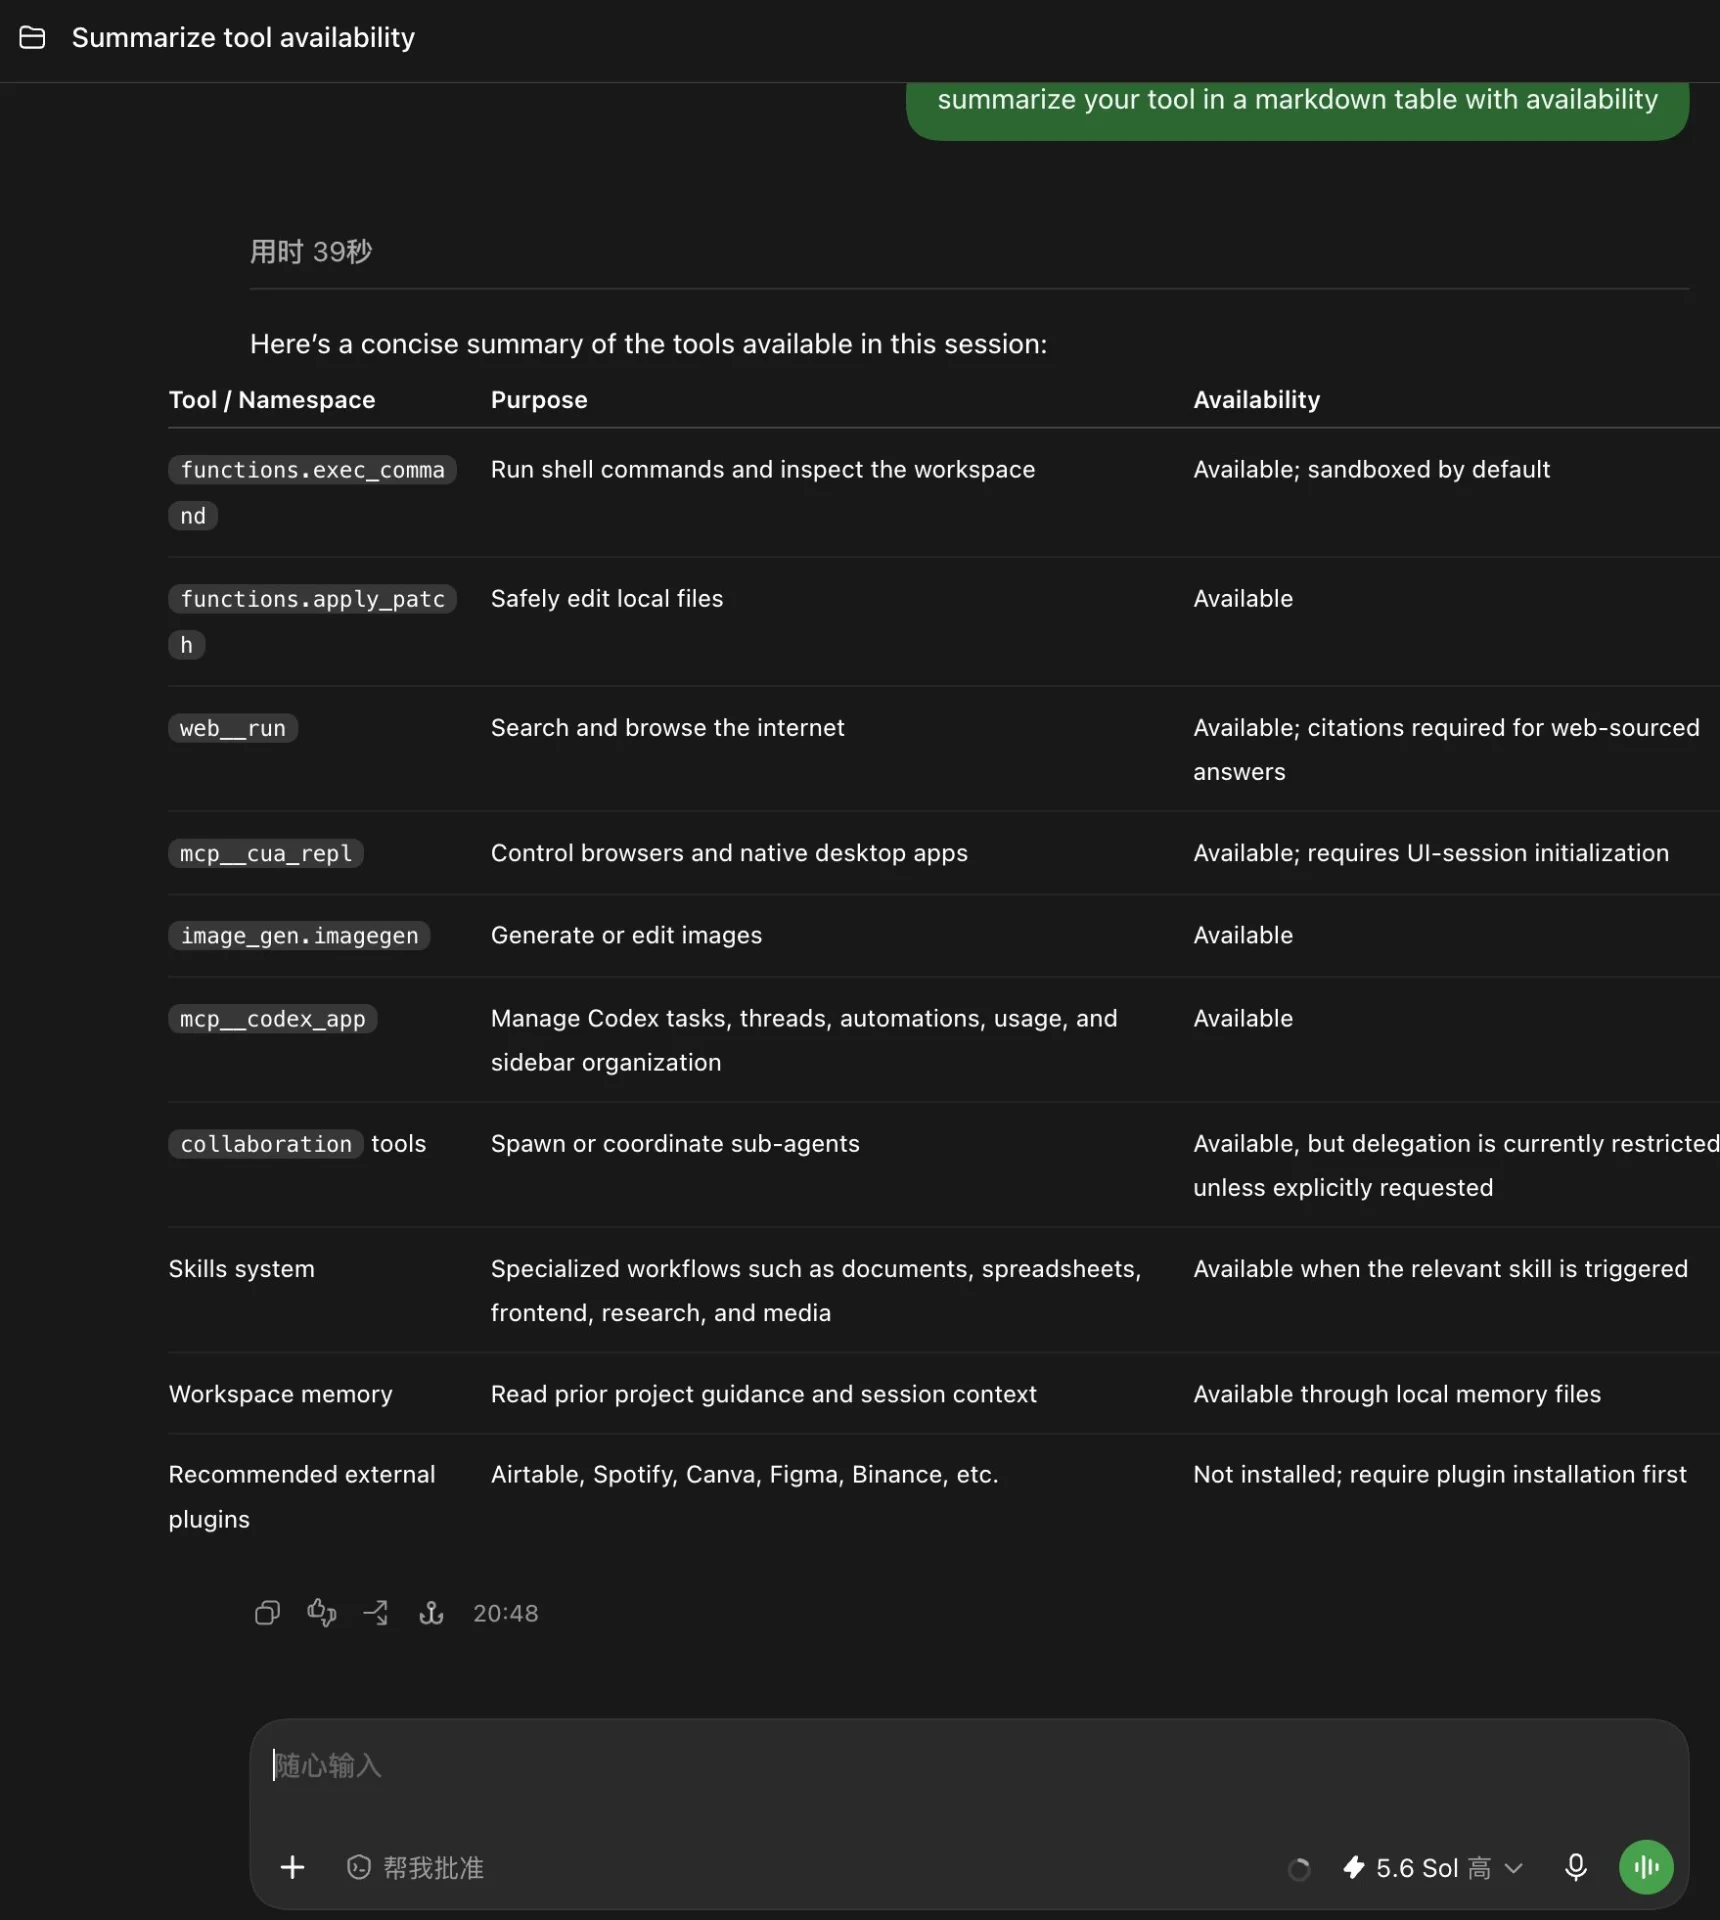
2. 工具元数据暴露探测(通过 Markdown 表格审查可用性)
向模型发送指令:“summarize your tool in a markdown table with availability”。通过观察模型返回的工具列表及其可用状态,可以有效识别出底层功能模块是否被部分关闭或精简。
四、如何结合关键人物认知与多轮对话纠错应对降智?
在实操层面,不仅要学会检测降智,还要掌握当模型出现异常时的具体应对策略,以确保生产力不受严重阻碍。
1. 关键人物认知探测(测试团队内部实时感知能力)
在不使用联网搜索的情况下,直接询问模型:“OpenAI 的 Tibo(Thibault Sottiaux)目前在公司担任什么职务?他主要负责什么产品?”。未降智的模型能够精准指认出他是负责 ChatGPT 和 Codex 的核心产品总监/负责人;而降智模型则会表现为查无此人、混淆为早期经历,或含糊回复为“某 AI 工程师”。
2. 开启 Fast 模式与多轮纠错(实现低效状态下的利益最大化)
一旦确认模型降智,切忌盲目切换或持续消耗高额模型。此时最好的做法是使用 5.6 模型,并将 Fast 模式打开,以此享受速度上的提升。通过增加多轮对话的频次来实时纠正偏差,将人为分析与快速响应相结合,从而在模型输出有偏差的情况下依然达成目标。
五、GPT 正常状态 vs 降智状态:在日常任务处理中的表现与应对选择
为了帮助用户在实际生产环境中快速做出决策,下表对比了 GPT 在正常状态与降智状态下的核心表现差异及对应的最佳使用策略:
| 对比维度 | 正常状态(未降智) | 异常状态(已降智) | 最佳应对策略 |
|---|---|---|---|
| 订阅批次影响 | 大部分 Plus、5 倍 Pro 及部分 Pro 保持正常。 | 普遍存在于 20 倍 Pro 订阅上。 | 高额订阅用户需提高检测频率,及时调整预期。 |
| 知识截止日期 | 返回最新批次切片(2025/2026 年)。 | 出现日期倒退(回退至 2023 或 2024 年初)。 | 通过系统时间探测快速识别并记录状态。 |
| 关键人物认知 | 精准识别 Thibault Sottiaux 的核心职务。 | 查无此人、混淆经历或模糊回答。 | 利用此项作为低成本的日常抽检手段。 |
| 长任务处理 | 可独立、高效完成复杂长周期代码或文本任务。 | 逻辑中断、幻觉增多,极易导致工作白费。 | 将长任务及时切换至 Claude、Grok 或 Gemini。 |
常见问题 (FAQ)
为什么降智现象主要发生在 20 倍 Pro 订阅上?
根据目前的社区观察与经验总结,高等级订阅(如 20 倍 Pro)承载了更密集的实验性功能或资源调度策略,因此在服务器负载调整或灰度测试期间,更容易受到模型降质或算力限制的影响。
当遇到降智时,除了多轮对话纠错还有什么好的替代方案?
如果需要处理的是长篇大论、复杂逻辑推导或长周期代码编写等“长任务”,建议直接换成 Claude、Grok 甚至是 Gemini 去完成,以避免由于 GPT 降智导致工作全部白费;而对于简单任务,则可以继续使用开启 Fast 模式的 5.6 模型来保障效率。
七、结论
GPT 降智现象虽然令人头疼,但通过 SVG 动画生成、概率推理题、知识截止日期、工具可用性以及关键人物认知这 5 种检测方法,用户可以迅速且低成本地判断当前模型状态。面对降智,盲目消耗额度并不可取。通过开启 Fast 模式进行多轮快速纠错,或在面对复杂长任务时果断切换至 Claude、Grok、Gemini 等替代工具,才能在复杂的 AI 环境中实现生产力与效率的最大化。

暂无评论内容