

💡 核心摘要
- Hypit 是一个支持 AI Agent 制作、剪辑、添加字幕与画中画并导出视频的开源项目,同时保留可编辑工程。
- 通过 Codex 组织素材生成与切镜编排,可完整复刻参考视频的构图、节奏及画中画效果。
- 支持双路线配置:有额度可直接使用 Hypit 内置服务,无额度则可灵活接入自定义第三方 API。
- 实操流程包含素材准备、首帧校验、分段视频生成及最终合成,适合用来高效低成本产出短视频内容。
一、理解 Hypit 核心架构与多工具分工原则
在利用 AI 工具复刻抖音爆款视频时,首先需要厘清流水线中各项工具的具体职责,避免出现定位混乱。Hypit 作为一个开源的 AI Agent 视频制作项目,主要与 Codex 及底层图像、视频模型协同工作。明确分工能够大幅降低排错成本并提高生成效率。以下是各工具的核心职责划分:
- Codex 的工作:作为代码与工程执行助手,Codex 负责解析用户的自然语言需求、检查并配置本机开发环境、读取并拆解参考视频的分镜结构、生成和修改工程源文件,并组织调用底层引擎完成自动化流水线。
- 图像与视频模型的工作:专门负责生成静态视觉资产与动态画面。例如,图像模型负责生成特定人物(如古装男子)在现代直播间中的首帧图像,视频模型则负责把首帧驱动为说话中的主播动态,并依据提示词生成穿插使用的外部车流空镜。
- Hypit 引擎的工作:作为核心编排中心,Hypit 记录所有生成的资产依赖,规定镜头序列与切换时钟,控制字幕展示时机与外观样式,管理画中画的位置、层级与圆角遮罩,并在素材齐备后调用底层渲染器合成最终成片。
为了兼顾不同读者的实际条件,本教程将生成模型配置明确拆分为两条独立路线:路线 A(使用 Hypit 平台内置服务)与路线 B(接入自定义第三方 API)。你只需在两条路线中挑选符合自身条件的一条完成配置,随后即可汇入共同的制作与编排流程。
二、如何正确配置运行环境与生成模型路线?
在正式开始视频制作前,必须完成基础环境的搭建以及模型路线的配置。根据用户账户的实际情况,可以选择内置服务或自定义 API 路线。
第一步:安装官方 Skill 与全局依赖(确保 Agent 具备项目控制权的关键操作)
在终端中执行官方 Skill 全局安装命令,将相关工具链部署到本机环境:
npx skills add hypit-ai/hypit -g
相关项目的安装入口可参考官方 Quickstart 手册。确保安装成功后,Codex 才能顺利接管后续的视频拆解与合成任务。
第二步:根据账户额度选择并初始化 API 路线(避免模型调用失败与计费混乱)
根据你是否拥有 Hypit 平台额度,选择以下对应的配置指令下发给 Codex:
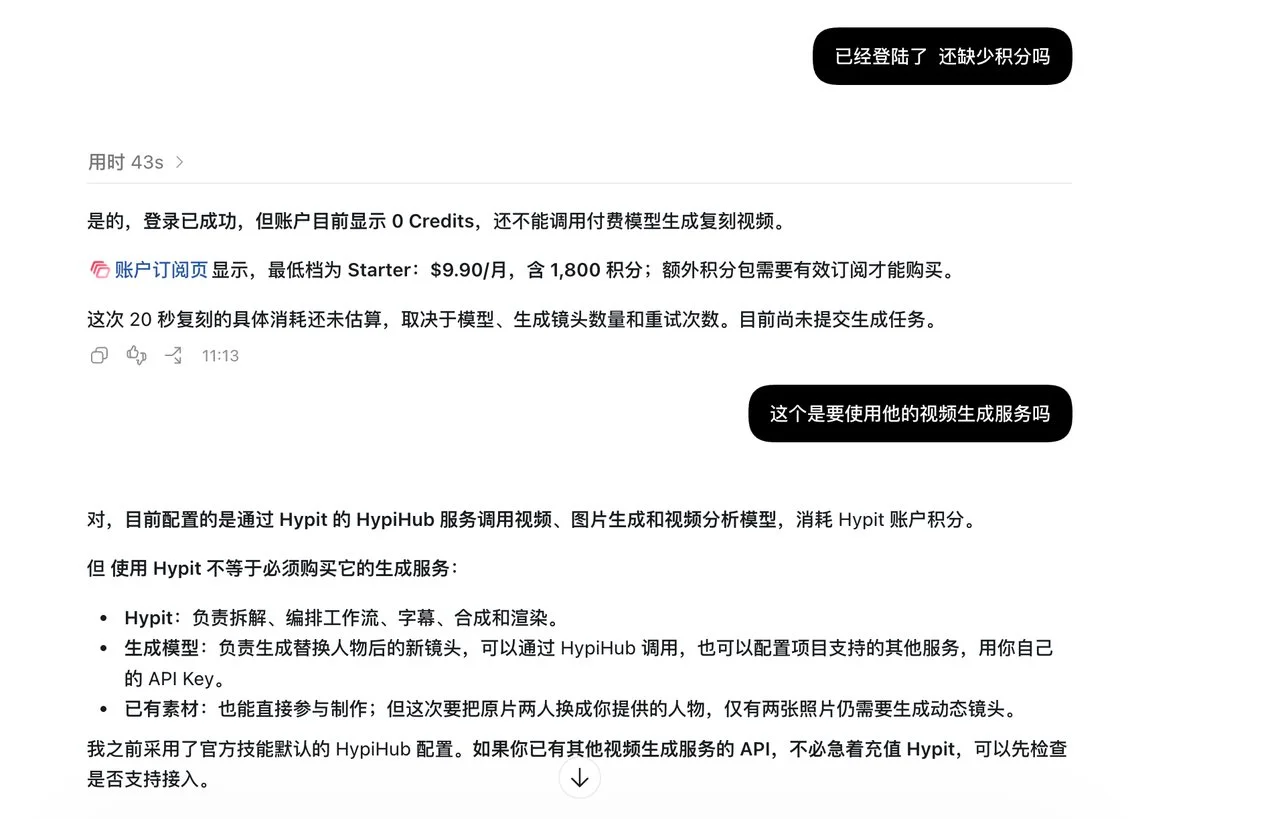
路线 A(内置服务):有额度的话,可以直接让 Codex 使用 Hypit 内置服务,不需要另外配置自己的 API。参考指令:
“请使用 Hypit 内置服务,帮我完成登录,检查可用模型和额度。先告诉我预计消耗多少,再开始生成。”
路线 B(自有 API):没有 Hypit 额度时,可配置并接入属于你自己的第三方 API 接口(如本例中使用 Google API 生成图片,使用 ZenMux 的 MiniMax H3 Max 生成视频)。参考指令:
“生图使用 Google API,视频使用 ZenMux 的 MiniMax H3 Max。请帮我完成配置并检查是否可用,需要付费测试时先说明费用。”
三、如何准备参考素材并设定精准的复刻范围?
高质量的输入素材是生成逼真视频的关键前提。在动手操作前,必须对参考视频和人物图像进行标准化处理,并对生成范围做出明确限定。
第一步:优选目标人物参考图(防范面部特征失真与光照不均的核心细节)
人物参考图应尽量选择五官立体、光照均匀、衣饰结构与发型细节清晰的单人照片。由于参考图本身不包含运动信息,仅凭一张静态图不能假定模型会自动做出与原片主播相同的耸肩、摊手或手势动作。
第二步:界定复刻片段与时长范围(避免 Codex 按整条长视频规划的防坑策略)
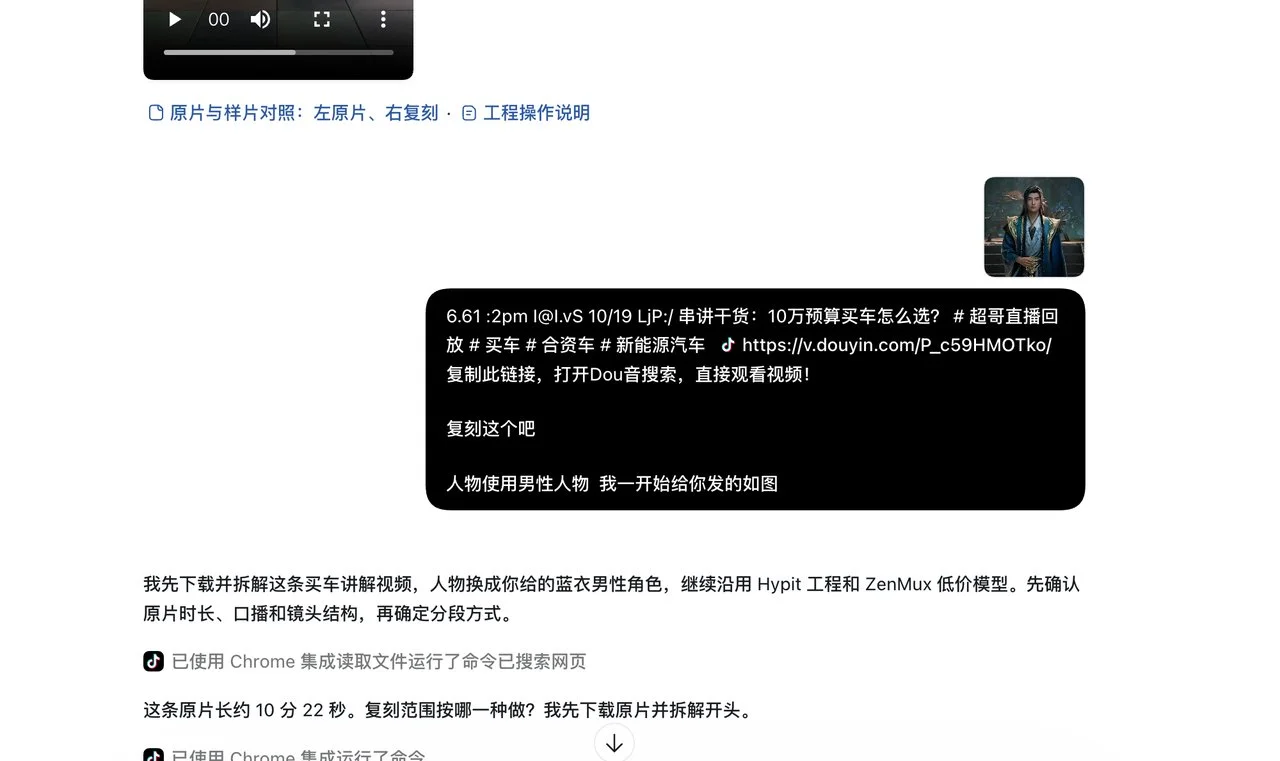
将参考视频链接和人物图片一起发给 Codex 时,必须明确限定复刻范围。例如,本例中只复刻开头 20 秒:
“请复刻这条视频的前 20 秒,人物替换成我提供的韩立。保留原片构图、切镜节奏、字幕和画中画,声音沿用原声。所有操作在同一个 Hypit 工程里完成。”
这里必须明确说明复刻范围,否则面对十几分钟的原片,Codex 可能会按整条视频进行宏大规划,导致算力浪费。
四、如何通过首帧校验与分段生成控制视频质量?
为了防止 AI 批量生成时出现画面崩坏或风格跑偏,必须采取“先看首帧、再生成视频”的分步控制策略。
第一步:拆解镜头并生成多场景首帧(拦截视觉风格偏差的关键卡点)
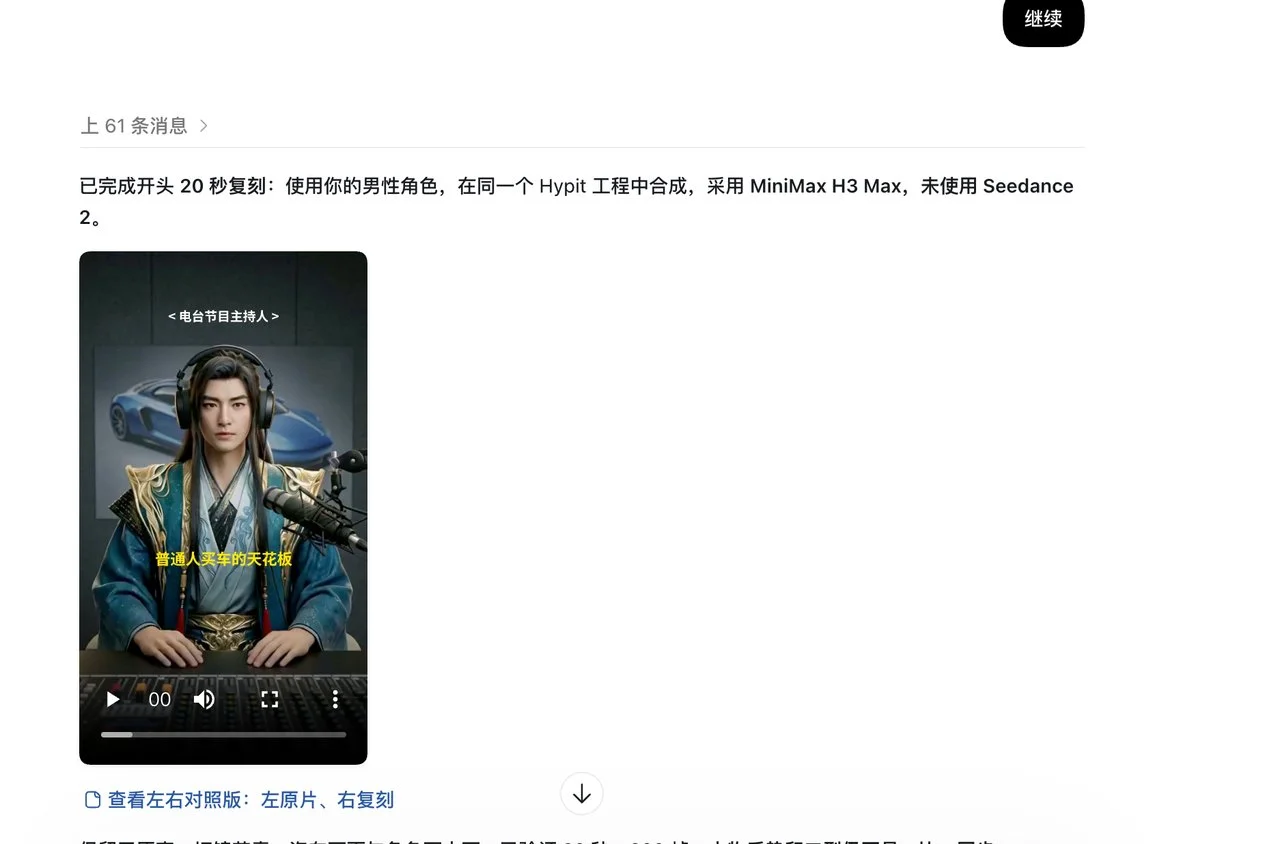
让 Codex 先拆解镜头,生成关键场景的首帧图像(例如直播间里的韩立、夕阳城市车流、白色奔驰隧道和日间街头车流)。这一步主要看人物像不像、服装对不对、场景有没有跑偏。首帧不满意,就先修改,再继续生成动态视频。
参考指令:
“请先展示四个场景的首帧。保留韩立的面孔、长发和蓝金衣袍,汽车画面不要带原主播、字幕或画中画,后面统一由 Hypit 添加。”
第二步:按确认首帧分段合成动态成片(复用已有资产的高效渲染操作)
首帧确认后,让 Codex 生成动态素材并由 Hypit 合成最终视频。模型负责生成画面,Hypit 负责切镜、字幕和画中画。
参考指令:
“请按照确认的首帧和预算生成动态素材,再按原片节奏合成 20 秒视频。汽车镜头出现时,把韩立放在下方居中的画中画里,配上原声和字幕。已经生成的素材直接复用,不要重复生成。”
五、Hypit 内置服务 vs 第三方自定义 API:在视频复刻项目中的选择与取舍
在实际开展 AI 视频复刻项目时,选择不同的模型接入方式会直接影响成本、画质和操作复杂度。以下是 Hypit 内置服务与自定义 API 路线的核心维度对比:
| 对比维度 | Hypit 内置服务 (路线 A) | 自定义第三方 API (路线 B) |
|---|---|---|
| 配置复杂度 | 极低,平台托管账号与额度,一键登录即可调用。 | 较高,需自行申请并配置 Google API、MiniMax H3 Max 等密钥。 |
| 模型灵活性 | 受限于平台内置托管的模型池,更新迭代由官方主导。 | 极高,可自由组合不同厂商的顶配图像与视频生成模型(如 Seedance 系列)。 |
| 成本可控性 | 依赖平台计费规则,适合轻度体验或快速验证。 | 按调用量或 API 实际消耗计费,适合深度定制与高频产出。 |
| 适用人群 | 新手小白、追求开箱即用效率的用户。 | 开发者、对画面画质有极高要求的专业视频创作者。 |
六、常见问题 (FAQ)
使用 Hypit 制作视频后,还能对字幕或画中画进行二次修改吗?
可以。Hypit 留下的不只是一条最终视频,还有一份可以继续修改的工程源文件。下次如果想换人物、改字幕或调整画中画位置,都可以直接从这份工程继续修改,而无需从头重新生成所有素材。
为什么生成的动作和口型没有达到一比一完美复刻?
这主要取决于所调用的底层视频生成模型能力。如果使用的是标准模型,动作和口型可能会存在细微瑕疵。建议尝试接入效果更好的模型(例如 Seedance 系列)来提升驱动逼真度,或者先找一条十几秒的短视频进行效果测试。
七、结论
通过开源项目 Hypit 与 Codex 的结合,我们能够以高度自动化的 Agent 工作流复刻抖音爆款视频。从环境配置、素材准备到首帧校验与分段合成,该工作流不仅显著降低了短视频工业化制作的门槛,还通过保留可编辑工程确保了后续优化的灵活性。感兴趣的读者可以先寻找一条十几秒的短视频进行上手实操,体验 AI 辅助视频生产带来的效率变革。

暂无评论内容