

💡 核心摘要
- 基于 283 万字语料(329 篇人类文章与 300 篇 AI 生成文章)进行对照实验,量化并识别真正的“AI 味”特征。
- 明确了 11 项通过检验的 AI 写作显著特征,包括段首零回指评论、拟人化喻体及空转冒号等。
- 纠正了传统认知误区,证实设问句和句长均匀度并非显著的 AI 特征。
- 发现不同主流模型(如 Claude、DeepSeek、GPT 等)的文风差异极大,单一模型的去 AI 味规则无法泛化。
一、为什么传统的去 AI 味方法容易踩坑与误伤?
在日常使用 AI 写作的过程中,许多人对输出内容的某些特定句式(如“不是A而是B”的对举结构、破折号滥用等)产生了明显的审美疲劳。互联网上虽然存在不少开源的去 AI 味项目,但在实际应用中往往会暴露出两个结构性问题:一是覆盖不全,许多能感受到的“AI 味”并未写入规则;二是误伤,部分人类自身的表达习惯也被一并消灭。这些问题的根源在于,多数规则源于个案观察和主观语感,缺乏系统性的数据检验。为此,有必要通过语言学中的对照实验,收集大规模人类与 AI 语料,逐项比较各种语言特征的频率差异,从而以科学的统计方式量化“AI 味”的本质。
二、如何通过多模型自动化 Workflow 构建 283 万字的高质量语料库?
语料的规模与质量直接决定了分析结果的泛化能力。如果样本量过小,容易将单一模型的个体倾向误读为 AI 的共性。例如,小样本测试曾误导性地得出“破折号是 Claude 独有特征”的结论,而当样本扩大后,发现 DeepSeek 的破折号频率甚至高于 Claude。为此,本项目构建了一个包含 329 篇真实人类语料(共 164.8 万字)以及 300 篇 AI 语料的庞大数据库,总计 629 篇文章、283 万字。
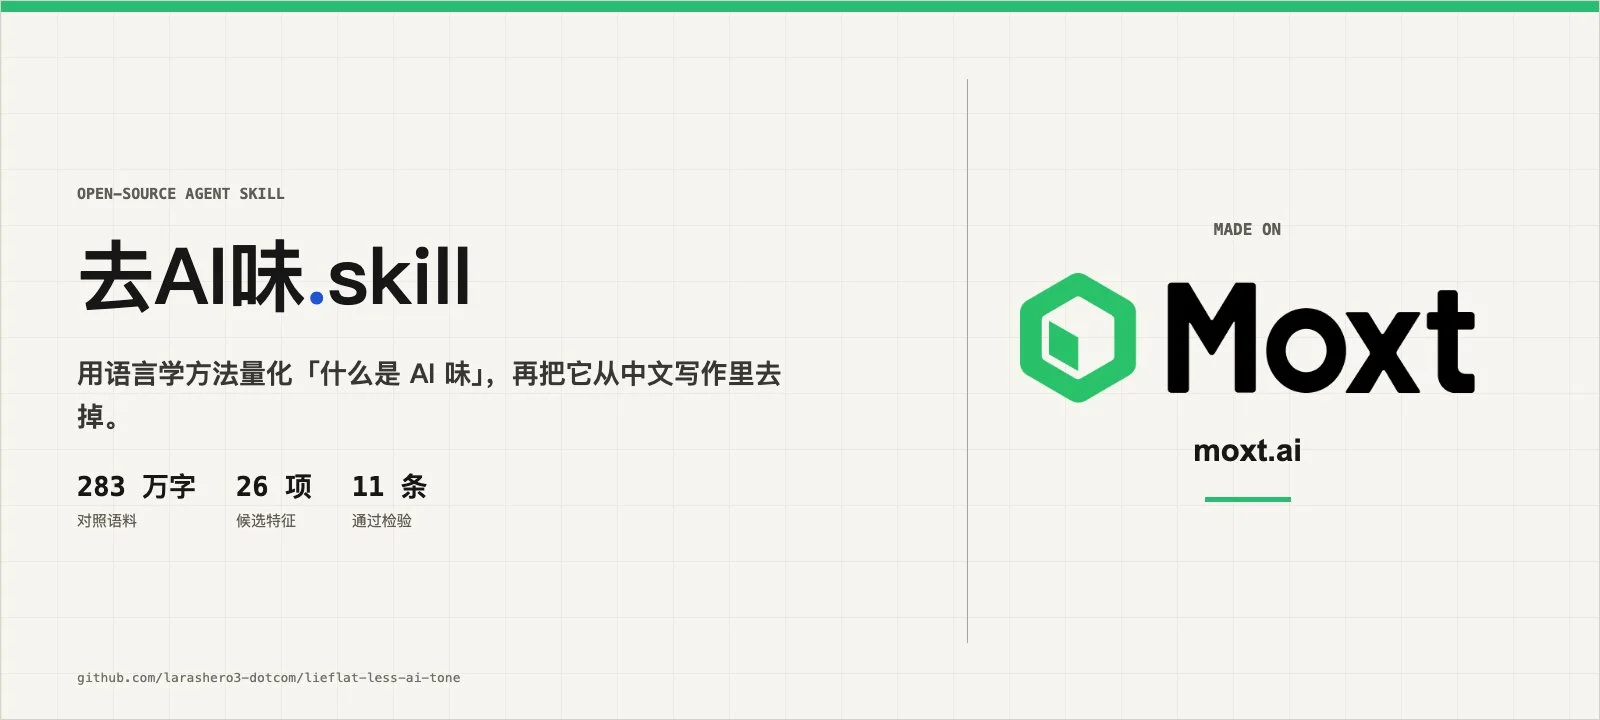
在 AI 语料生成环节,必须严格控制变量:
1. 自动化 Agent 环境搭建(防范单模型偏差与主观干扰的关键操作)
新建了包含 5 个主流写作模型(Claude Opus 4.6、DeepSeek V4-Pro、Gemini 3.1 Pro、GPT 5.6 Sol、Kimi K3)的自动化 Agent workflow,在不联网且不给任何风格指令的统一条件下,让各模型针对相同的话题和体裁生成文章,每模型生成 60 篇,确保测试基准的客观公正。
2. 频率倍数阈值筛选(排除体裁与偶发误差的核心统计准则)
采用严格的量化对比方法:设定当 AI 语料的使用频率达到人类文章频率的两倍以上时,方可被判定为显著的“AI 味”特征;0.8 到 1.25 倍之间视为无差异;低于 0.8 则表明人类使用更多。同时施加统计约束,确保人类各组数值相差不超过 5 倍,且特征必须落实到可定位的句段和词形上。
三、哪些特征通过了严格检验并构成了真正的 AI 痕迹?
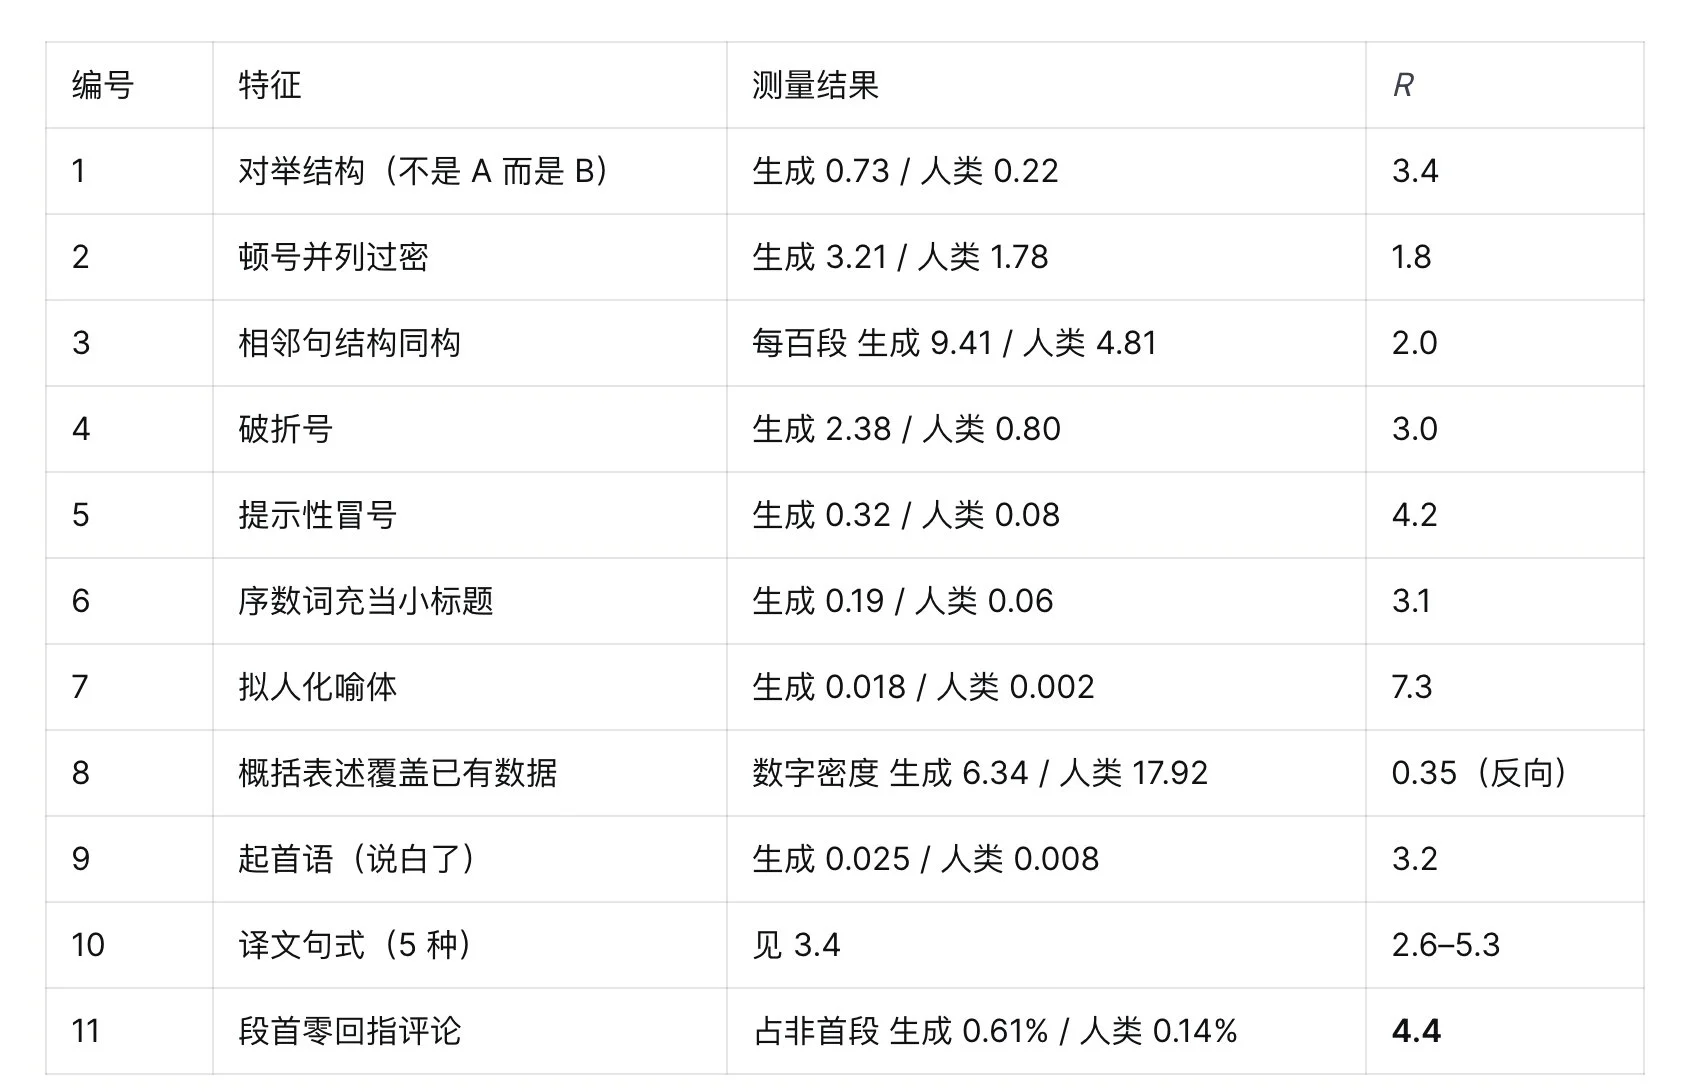
在最初测试的 26 项候选特征中,最终仅有 11 项通过了统计检验,且这些特征主要集中在篇章和结构层面,词汇和标点反倒不明显。其中,区分力较强的特征包括:
1. 段首零回指评论识别(防范段落衔接生硬导致可读性下降的技术细节)
数据表明,AI 在段落开头直接抛出无指代对象的评价(如“听起来像一条功能描述”)的频率是人类的 4.4 倍,导致读者必须回翻上文才能理解。修改方法极为简单:只需补上“这”等指代词即可显著改善生硬感。
2. 拟人化喻体与空转冒号筛查(规避无效修辞与信息空转的优化策略)
实测发现 AI 使用比喻的总体频率并不比人类高,但在“拟人化比喻”(如“像一位不知疲倦的助手”)的使用上频率明显偏高。此外,专门用来引出列表而不带实际信息的“空转冒号”(如“主要有以下几种场景:”)以及提示语冒号(如“核心是:”)也是 AI 痕迹重灾区,其差异倍数分别达到 9.4 倍和 3.8 倍。
四、如何打破流行认知并修正关于 AI 写作的常见误区?
通过严谨的数据对照,许多流传甚广的“AI 味”认知被证实并不成立:
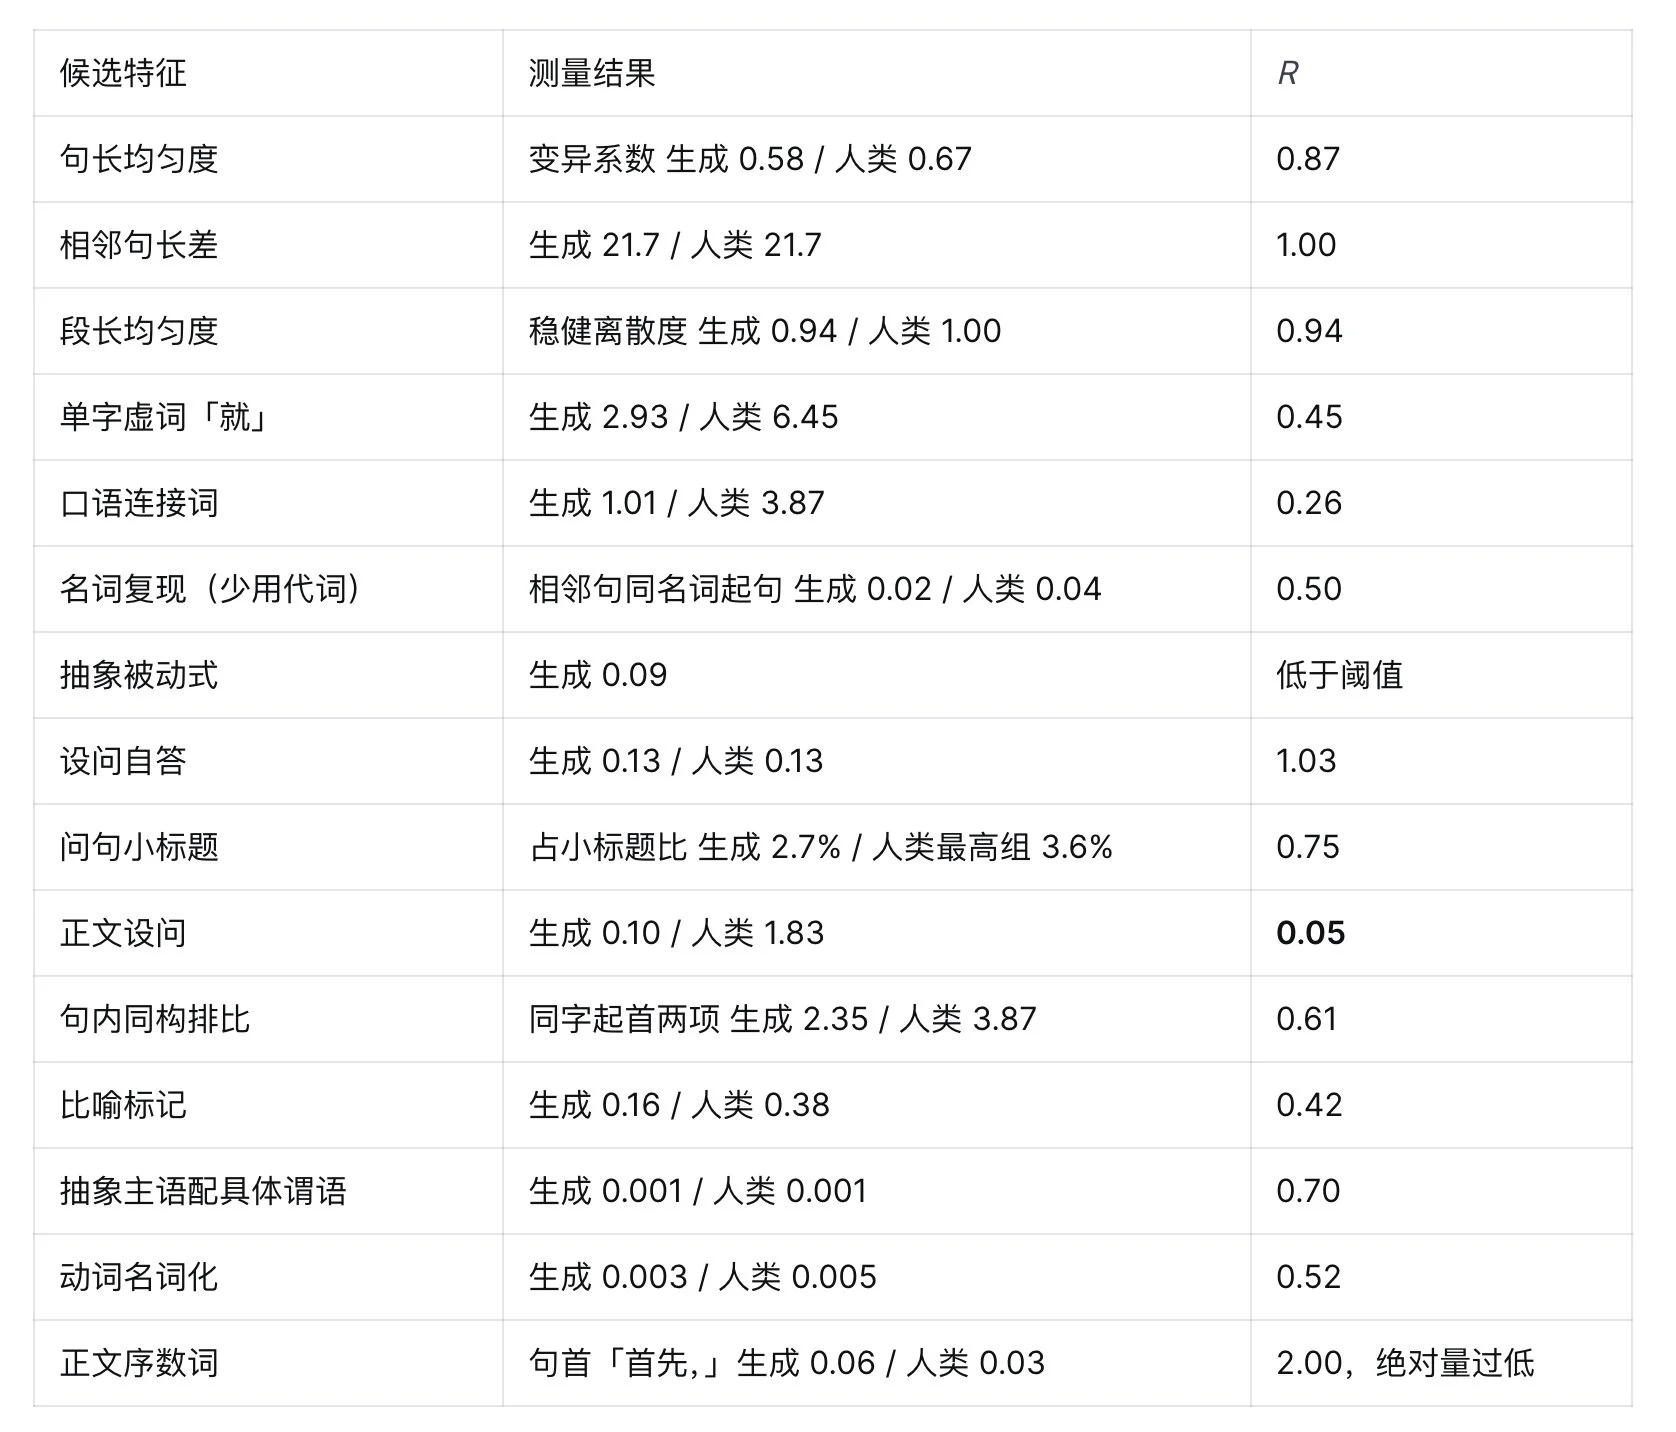
1. 正文设问句频率校准(纠正盲目删减问句导致表达失真的防坑指南)
“AI 爱设问”是常见的去 AI 味建议,但实测表明人类的设问频率反而是 AI 的 17 倍(人类 1.83/千字,AI 0.10)。如果盲目按照“减少设问”去修改文章,反而会背离人类的真实写作习惯。
2. 句长均匀度异常排查(防范程序 Bug 导致虚假统计结论的校验步骤)
初期数据显示 AI 的句长变异系数是人类的 51 倍,排在规则首位。深入追查后发现是切句程序存在 Bug(将 Markdown 表格和长列表误判为单句,甚至出现 19335 字的段落)。修正后重测发现两侧并无显著差异,这警示我们在制定规则前必须通过抽样严格校验底层命中范围。
五、不同大模型 vs 人类基准:在写作偏好与文风特征上的选择与取舍
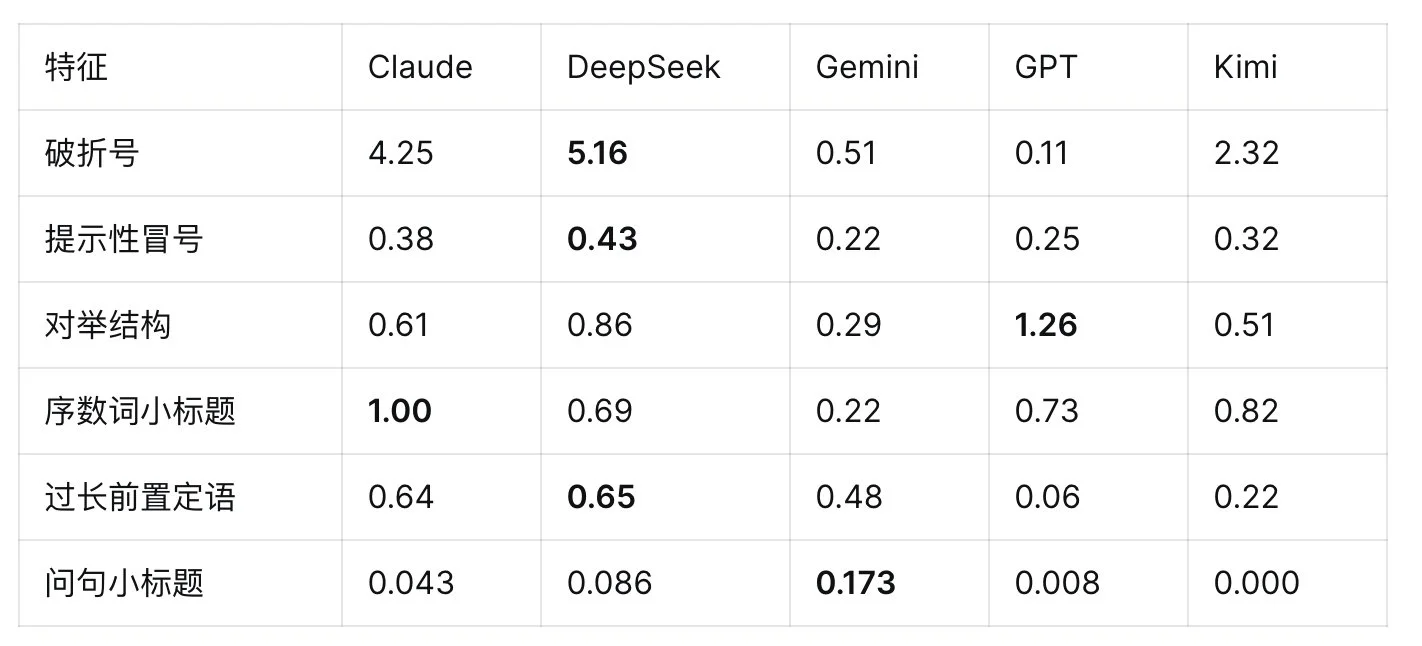
研究意外发现,不同主流大模型之间的写作偏好差异巨大,根本不存在单一、统一的“AI 文风”。下表对比了各模型在核心语言特征上的表现差异:
| 语言特征维度 | DeepSeek V4-Pro | GPT 5.6 Sol | Claude Opus 4.6 | Gemini 3.1 Pro | 人类基准表现 |
|---|---|---|---|---|---|
| 破折号使用频率(每千字) | 5.16 次 | 0.11 次 | 4.25 次 | 较低 | 差异显著 |
| 对举结构密度(每千字) | 中等 | 1.26 次 | 中等 | 0.29 次 | 因体裁而异 |
| 提示性冒号偏好 | 高 (0.43) | 偏低 | 高 (0.38) | 偏低 | 自然分布 |
| 问句小标题出现率 | 极低 | 中等 | 中等 | 一骑绝尘 (0.173) | 1-2次/篇 |
六、常见问题 (FAQ)
为什么基于单一模型总结的去 AI 味规则往往会失效?
因为不同模型之间的写作风格差异可达数十倍。例如,DeepSeek 的破折号频率是 GPT 的近 50 倍,Gemini 的问句小标题远高于其他模型。拿某个模型总结出来的特征去套用在另一个模型上,极易产生严重的误判。
为什么不能盲目采用“减少设问句”来去除 AI 味?
对照实验数据显示,人类写作中使用设问句的频率实际上是 AI 的 17 倍左右。盲目删减设问句不仅无法去除 AI 味,反而会使文章结构变得死板,背离人类自然的表达习惯。
七、结论
通过对 283 万字语料的系统性定量分析,我们揭示了真正的“AI 味”主要集中在篇章与结构层面,如段首零回指评论、拟人化喻体及空转冒号等,而非流传的设问句或句长差异。然而,由于写作行为的高度主观性,单纯依靠 Prompt 或后处理 Skill 只能解决局部的文风优化问题。从根本上提升 AI 的写作水平,仍需等待大模型在底层预训练阶段实现突破。本研究所开源的 skill(lieflat-less-ai-tone)为深度自媒体及媒体文章场景提供了可靠的数据支撑与优化参考。

暂无评论内容