

💡 核心摘要
- 现象根源:大模型和写作者由于害怕被挑刺和承担责任,普遍陷入了满嘴叠甲的“防御性写作”与拒绝下结论的“防越界写作”。
- 实验支撑:最新学术研究表明,触发大模型变怂的机关往往是“审稿”二字,而通过“挑刺、筛选、动笔”三分离的 Agent 架构可有效根治废话。
- 工具落地:整理了 6 个开源 Skill 仓库及免责提示词补丁,帮助用户在日常写作和论文润色中恢复正常表达。
- 避坑指南:警惕“反防御”变成“胡乱造假”,在删减限定词的同时务必核对事实边界,避免 AI 为撑场面盲目编造数据。
一、为什么现在的文章和AI越来越不说人话?
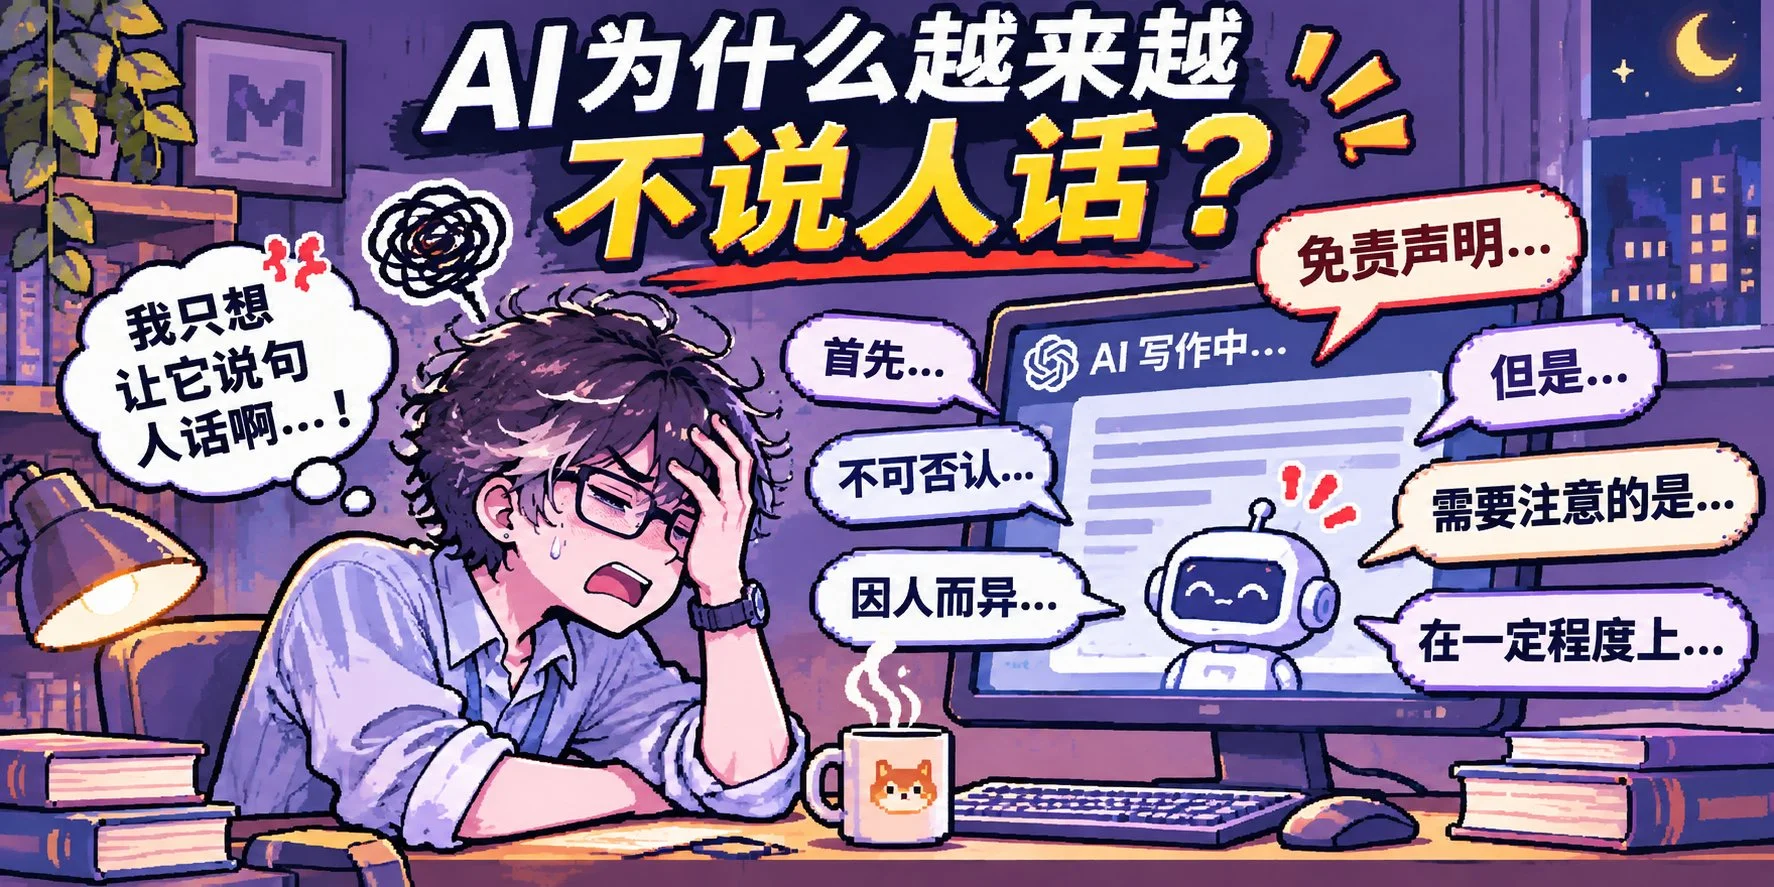
不知道你发现没有,现在的文章和 AI 生成的内容,越来越不敢说人话了。明明一句话就能说透的事,非要绕上三四段弯子:想骂一款软件难用,得先声明自己“并不否认它的创新价值”;想吐槽某个工具太贵,得先承认它“确实在部分场景提高了效率”;用 AI 改完初稿,稿子里居然凭空多出一堆各种免责声明词。
这两个月中文圈对这种现象吐槽极多,特别是 Gpt 的写作十分明显,即便是装了各种 skills 仍然效果没有一点点起色。究其原因,现在的大模型习惯了怕被挑刺的「防御性写作」以及怕得罪人、不敢下结论的「防越界写作」。本文将把这两大毛病的病因、2 篇专门研究它的最新论文、以及现在能直接拿来用的 6 个开源 Skill 和提示词补丁放在一起,一次性讲透怎么逼自己和 AI 正常说人话。
二、为什么传统的 AI 写作会频繁陷入防御性写作?
第一种:满嘴叠甲的防御性写作(提前铺好退路以应对杠精)
【核心结论】防御性写作的本质是写作者或 AI 在亮出观点前,先替自己把退路铺好,其唯一的作用就是提前堵住评论区杠精的嘴。【解释依据】原本只想表达一句大白话:“这个 AI Agent 很难用,价格贵,跑起来还慢。”一旦进入防御模式,写出来就成了:“首先,我并不否认这款产品在特定场景下具有一定价值。鉴于不同用户的使用习惯存在客观差异,以下评价仅代表个人主观体验,不构成对产品整体质量的否定……”写了快一百字,连正题的边都没摸到。【场景化建议】在日常创作中,必须强行砍掉这种毫无信息增量的预防性废话,如果某句话存在的唯一目的只是为了防止被人挑刺,并不推进论证,应当直接删除。
三、如何通过分离 Agent 架构根治防越界写作?
第三种:死守端水公式的防越界写作(逃避判断与拒绝得罪人)
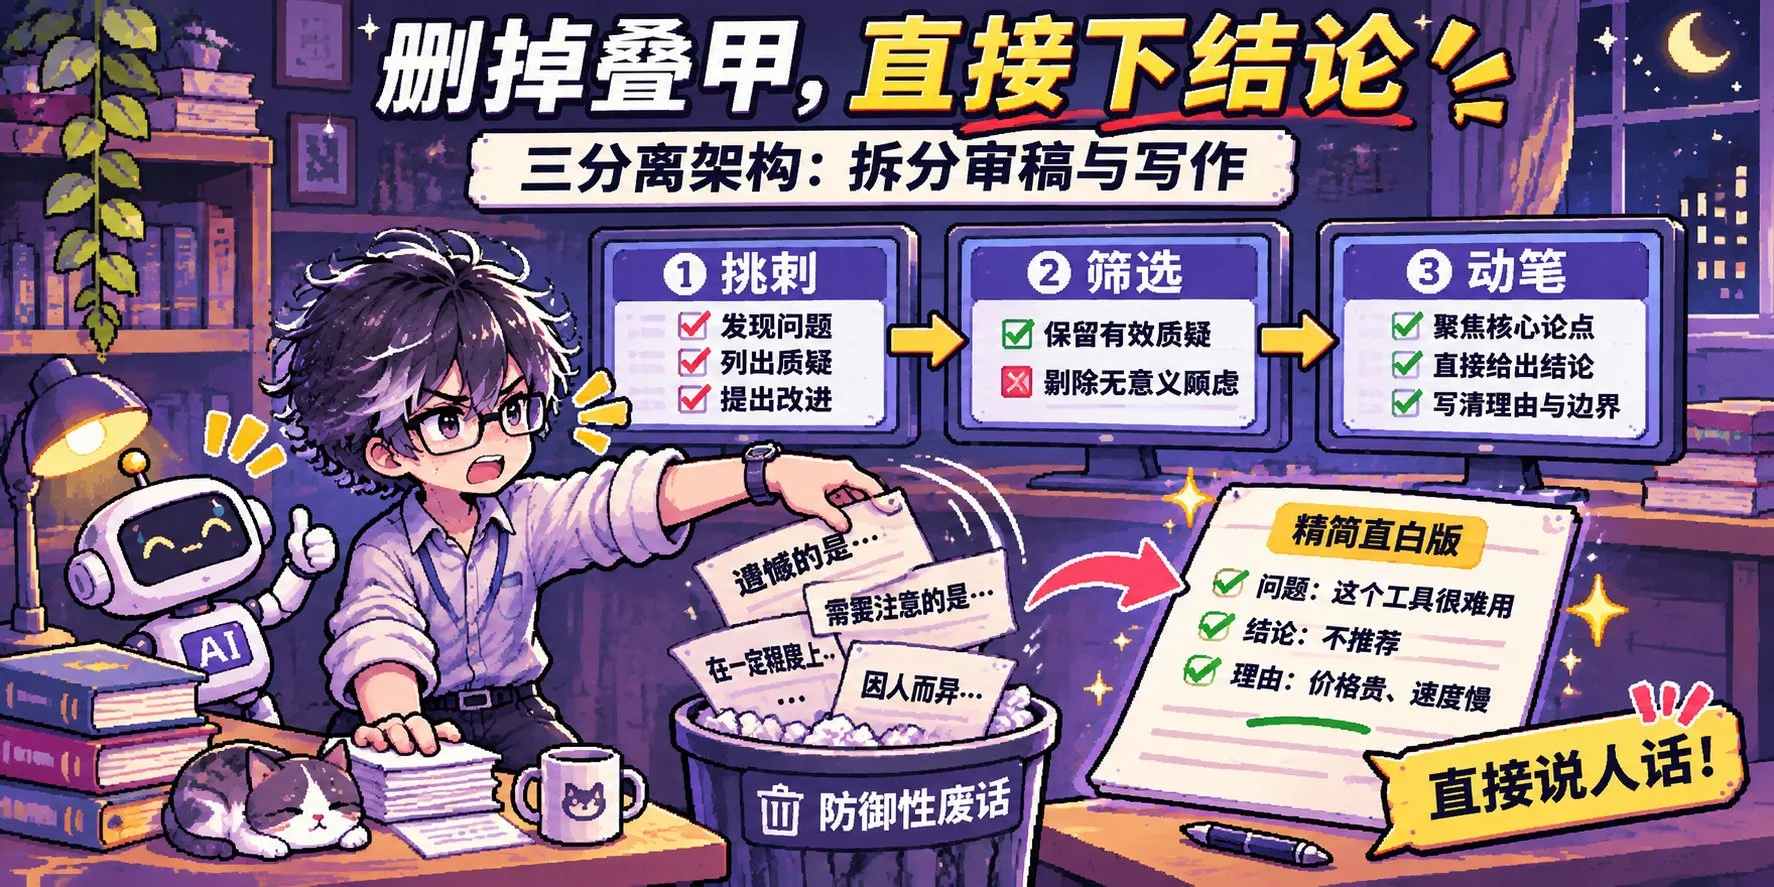
【核心结论】防越界写作表现为永远死守着同一套“端水公式”:夸完 A 立刻夸 B,提一句缺点立刻找补“未来可期”,最后甩出一句“没有最好的产品,只有最适合你的选择”。【解释依据】根据最新研究,把“审稿”和“动笔”拆开就能根治这一顽疾。如果让同一个 AI 边想审稿意见边写稿会变怂,将其拆成三个独立的 Agent(一个专门挑刺、一个负责筛选真问题、最后一个只管动笔写)能让防御性废话从 59 处暴降到 2 处。【场景化建议】在处理长篇报告时,建议照搬“挑刺、筛选、动笔”三分离的多 Agent 策略,确保写手 Agent 听不到被筛掉的废话质疑。
四、如何选择适合特定场景的开源 Skill 仓库?
第四步:按场景精准匹配(从论文润色到日常职场的开源解决方案防坑选择)
【核心结论】目前 GitHub 上已经有一批专门治防防御性写作的开源 Skill,用户需要根据自身具体应用场景进行针对性选择。【解释依据】针对不同需求,开源社区提供了多样化工具:如主力仓库 Adkid-Zephyr 适合无脑装载的论文润色;Kiterlin 适合正面界定派;Smoothsailing0 专门针对中文社科人文类文章调优;ZF-Utokyo 适合投稿前做清洁与写 Rebuttal;justairr 提供了叠甲检查器;Yila-AI 覆盖了日常与职场提示词合集。【场景化建议】改论文或商业文档时,切勿盲目安装,应当根据“改论文、写社科、审稿回复、体检叠甲、日常汇报”等不同细分需求挑选对应的开源项目。
五、防御性写作工具 vs 传统 AI 润色:在学术论文与商业报告场景下的选择与取舍
【核心结论】在不同的写作场景和优化维度下,传统 AI 润色工具与专门的抗防御性写作 Skill 存在显著差异,用户需要根据实际产出目标权衡取舍。
| 对比维度 | 传统 AI 润色工具 | 抗防御性写作开源 Skill / 提示词 |
|---|---|---|
| 核心目标 | 修正语法错误、提升句式流畅度与通用可读性 | 剥离免责声明、消除和稀泥废话、锁定事实边界 |
| 对“审稿”指令的反应 | 容易触发 AI 自我审查,导致限定词和叠甲废话暴增 | 通过拆分 Agent 或强规则约束,强制模型直接下达结论 |
| 适用场景 | 日常闲聊、基础邮件、不涉及深度观点的通用文本 | 学术论文改写、深度行业评测、硬核商业报告 |
| 潜在风险 | 文章冗长、观点模糊、缺乏核心洞察和决策价值 | 若提示词过于极端可能导致 AI 产生凭空捏造假数据的幻觉 |
六、常见问题 (FAQ)
为什么只要跟 AI 提到“审稿”二字,它写出来的文章就会变得满嘴叠甲?
根据《Defensive Writing in GPT Models》的研究发现,“审稿”二字会直接触发大模型的自我审查机制。模型会揣摩审稿人可能挑剔的点,从而在原文中凭空加入大量在原始材料里根本找不到依据的限定词和免责声明,导致文章变得极其难读。
使用反防御性写作提示词时,有哪些必须注意的副作用?
第二篇论文测出一个非常关键的副作用——如果你只在提示词里干巴巴地写一句“严禁使用防御性写作”,模型虽然把叠甲废话压低了,但它为了显得底气十足,居然可能凭空编造出大量没有依据的假事实。因此删完限定词后,务必核对它有没有为了撑场面而塞入假数据。
七、结论
面对大模型与文章中日益严重的防御性写作与防越界写作,盲目增加免责声明或套用端水公式只会让内容丧失决策价值。通过理解论文揭示的底层病因、采用“挑刺、筛选、动笔”三分离的 Agent 架构,并合理运用开源 Skill 与精准的系统提示词规则,我们才能彻底根治废话,逼自己和 AI 恢复正常说人话的能力。建议在动手润色时管住指令、打上轻提示,并在改完后严格进行真伪验证。
暂无评论内容