
💡 核心摘要
- 明确需要独立统计的 5 本账:抓取、访问、引用、引荐与转化账,避免将不同维度的指标混为一谈。
- 利用开源自托管工具 GEOInflow 整合浏览器脚本、服务器日志与内容目录,实现多维度数据统一看板。
- 从数据资格、页面覆盖、响应状态、引用留证与真人转化五个步骤,系统性排查网站 GEO 流量卡点。
- 通过 7 天排查落地计划,锁定核心关键页并持续追踪优化效果。
一、为什么大多数站长做 GEO 会踩坑?
做面向生成式 AI 搜索的内容与网站优化(GEO)时,很多独立开发者和小团队常常遇到“有布局却没流量”的困境。问题的根源在于,没有厘清 AI 流量从抓取、访问到转化的全链路数据。对站长来说,第一步需要把最重要的 20 个页面挑出来,把服务器日志、内容目录、访客与转化数据接起来,再按平台和落地页逐步排查。这样你才能准确回答三个核心问题:AI 到底访问了什么?用户有没有点进来?进来以后做了什么?
二、为什么必须把这 5 本账分开?
在进行 AI 流量分析时,必须严格区分以下 5 本账,它们之间不能互相代替:
- 抓取账:哪个身份在什么时间请求了哪个 URL?
- 访问账:返回了什么状态,是否拿到了可用内容?
- 引用账:在一组明确的问题里,AI 回答有没有引用你的页面?
- 引荐账:用户有没有从 AI 平台点击进入网站?
- 转化账:这些访问有没有完成注册、有效咨询或产品里的关键任务?
日志出现某个爬虫,只能支持相应的请求记录;回答里出现你的链接,也不能证明有人点击或付费。尤其要分清爬虫用途。OpenAI 的 GPTBot 主要用于可能参与模型训练的内容采集,OAI-SearchBot 服务于搜索,ChatGPT-User 用于某些用户主动触发的访问。把它们合成一个“ChatGPT 流量”,你就很难判断下一步该改什么。身份和用途需以官方说明为准:OpenAI 爬虫官方说明。
三、如何使用 GEOInflow 整合三类关键数据?
GEOInflow 是一套 MIT 开源、自托管的网站与 AI 爬虫分析工具。它把访客、AI 引荐、服务器抓取日志和内容目录放到同一个网站里查看。核心统计无需模型 API Key,浏览采集默认不使用 Cookie;自托管仍需要你承担服务器和维护成本。GEOInflow 开源地址。
真正要接的是三类输入,每类回答不同问题:
- 浏览器统计脚本:观察执行脚本的访问、来源和业务事件。
- 服务器或 CDN 日志:补充没有执行脚本的请求,观察爬虫身份、路径和响应。
- Sitemap、CSV 或 JSON 内容目录:告诉系统,你希望拿哪些已知页面来核对覆盖。
只装统计脚本,抓取观察仍然缺少输入;只导日志,也无法知道真人进站后有没有完成业务动作。先用一份小日志验证字段,比一开始就折腾自动接入容易排错。导入后核对时间、路径、状态码和 User-Agent,再看有效行、拒绝原因和处理状态。确认数据对得上,再接持续采集。GEOInflow 快速上手文档。
四、如何部署高精度的 AI 运行环境?
准备好 Docker Engine 或 Docker Desktop、Docker Compose V2,以及能下载镜像和依赖的网络。在项目源码根目录执行:
sh scripts/liekan-deploy.sh默认入口是 http://127.0.0.1:3002。首次安装按文档登录并立即修改初始密码;正式使用再配置域名、HTTPS 和可信反向代理。GEOInflow 部署文档。
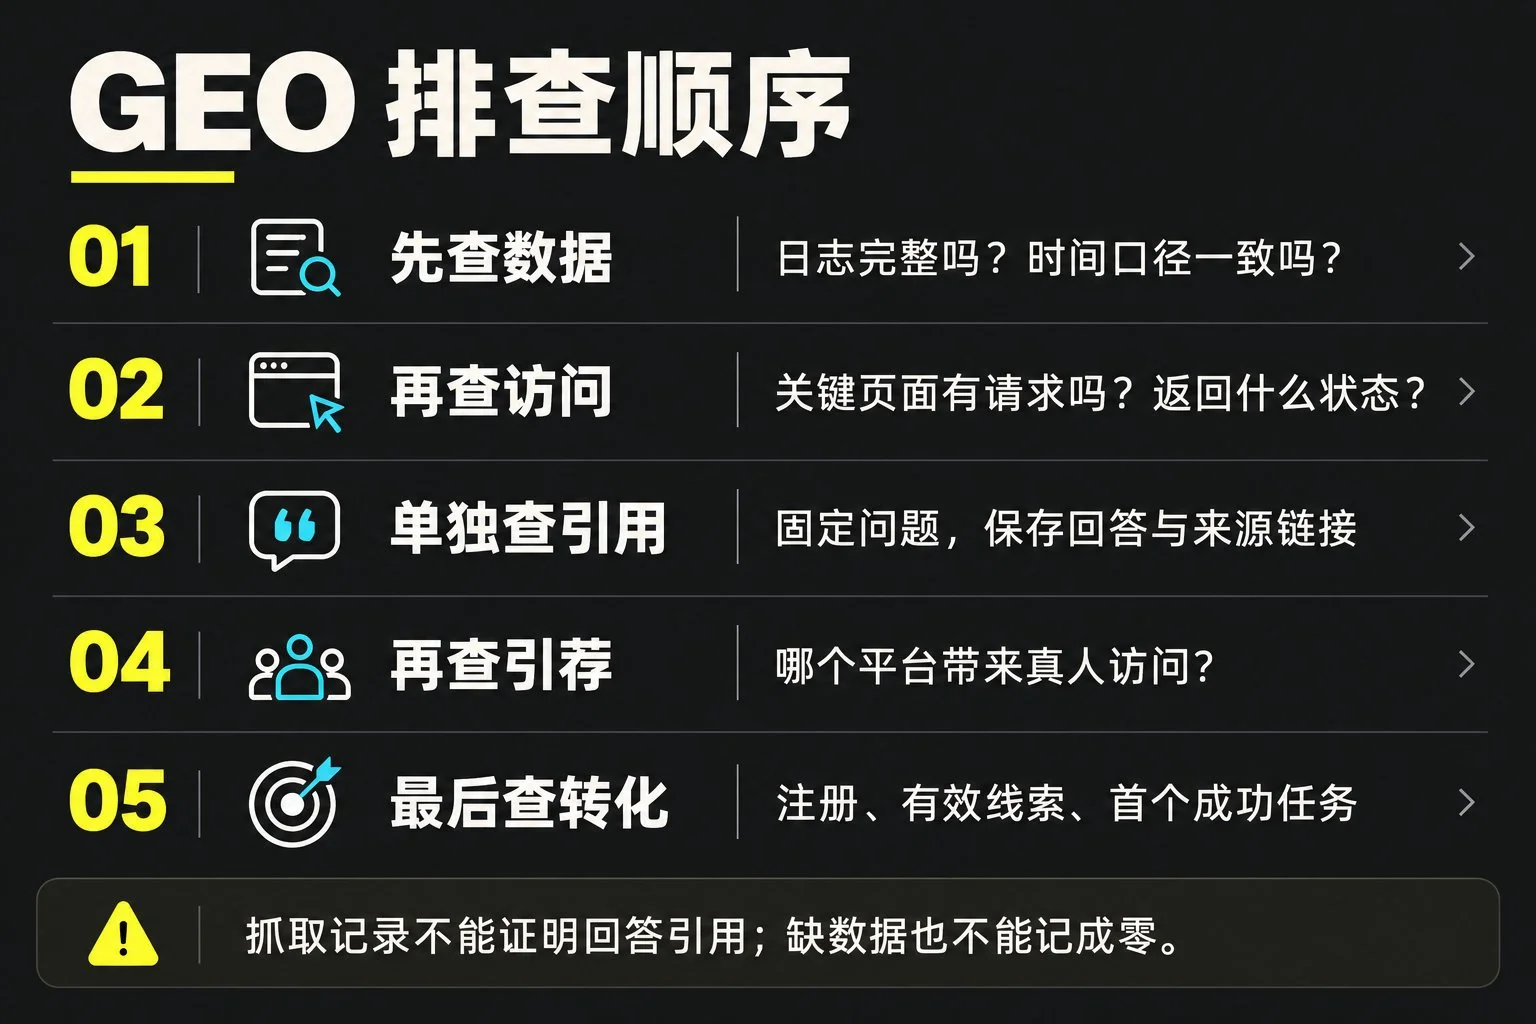
第一步:无损脚本埋点验证(防范前端埋点失效的关键操作)
打开自己的测试页面,脚本和接收请求成功,后台能找到对应访问。
第二步:增量日志导入核对(防范时区错乱与错站污染的关键操作)
导入一小段日志,抽查几条时间、URL、状态和 UA,确认没有错站或错时区。
第三步:内容目录结构展开(防范 Sitemap 路径遗漏的关键操作)
导入页面目录,核对主机名、页面数量和路径;Sitemap 索引要先展开成具体页面列表。
第四步:核心业务事件分离(防范伪转化干扰真实评估的关键操作)
配一个关键事件,亲手走完一次流程,确认事件只在动作成功后记录。例如“点击注册按钮”和“注册成功”应该分开。做 AI 工具的,还可以继续记录“第一次成功生成结果”,这样才看得见注册之后的掉队。
GEOInflow vs 传统网站统计工具:在 AI 流量与爬虫监控场景下的选择与取舍
| 对比维度 | GEOInflow(开源自托管) | 传统网站统计工具(如 Google Analytics / 百度统计) |
|---|---|---|
| 数据隐私与控制 | 完全自托管,数据自主掌控,默认不使用 Cookie | 第三方托管,受平台隐私政策与数据合规限制 |
| AI 爬虫识别 | 原生支持服务器日志解析,精确区分 GPTBot、OAI-SearchBot 等 | 主要针对人类浏览器访问,AI 爬虫流量常被过滤或归类为 Direct/Unknown |
| 数据源融合 | 同时整合浏览器脚本、CDN/服务器日志与 Sitemap 目录 | 仅依赖前端 JS 脚本埋点,无法获取无脚本的爬虫抓取数据 |
| API 依赖与成本 | 核心统计无需模型 API Key,需承担服务器和维护成本 | 多为免费或按量付费,但高级定制功能受限 |
六、常见问题 (FAQ)
GEOInflow 需要配置模型 API Key 才能运行吗?
不需要。GEOInflow 的核心统计功能无需模型 API Key,且浏览采集默认不使用 Cookie,但自托管需要用户自行承担服务器和维护成本。
为什么不能用“注册数 ÷ 爬虫请求数”来算获客转化率?
因为这种计算方法混合了机器请求和真实用户行为,无法说明用户在哪一步流失,分子和分母必须保持在同一平台范围与时间口径内。
七、结论
做 GEO 优化不能盲目凭感觉,必须通过扎实的数据采集与全链路排查来锁定流量卡点。通过 GEOInflow 将服务器日志、访客行为与内容目录打通,配合 7 天的落地排查节奏(第 1 天定关键页与时区,第 2 天接脚本验数据,第 3 天接日志导目录,第 4 天查访问错误,第 5 天调单页内容,第 6 天查引用引荐,第 7 天核对数据闭环),你可以清晰掌握 AI 抓取与用户转化的真实状况,从而稳步提升生成式引擎中的曝光与转化表现。
暂无评论内容