

💡 核心摘要
- Jev 是由 TypeSafe AI 创始人 Diogo Almeida 推出的一款专门针对软件“判断任务”设计的 System One Models。
- 它摒弃了自由文本生成,专注于 Choice(选择)、Score(打分)和 Noul(概率判断)三大核心特性。
- 相比传统大语言模型,Jev 具备极高的响应速度(约 85 毫秒)与极低的调用成本(百万输入 token 仅需 0.042 美元)。
- Jev 与大语言模型并非互斥,而是互补关系,特别适合用于 AI Agent 的前置筛选与快速决策环节。
一、为什么传统的通用大模型在执行自动化判断时会遭遇效率与成本瓶颈?
在当前的 AI 领域,各大厂商的竞争主要集中在文字、图片、音频和视频等生成内容的方向上。然而,当开发者试图将 AI 能力嵌入软件以自动完成日常逻辑时,往往会面临通用大模型带来的效率与成本双重限制。
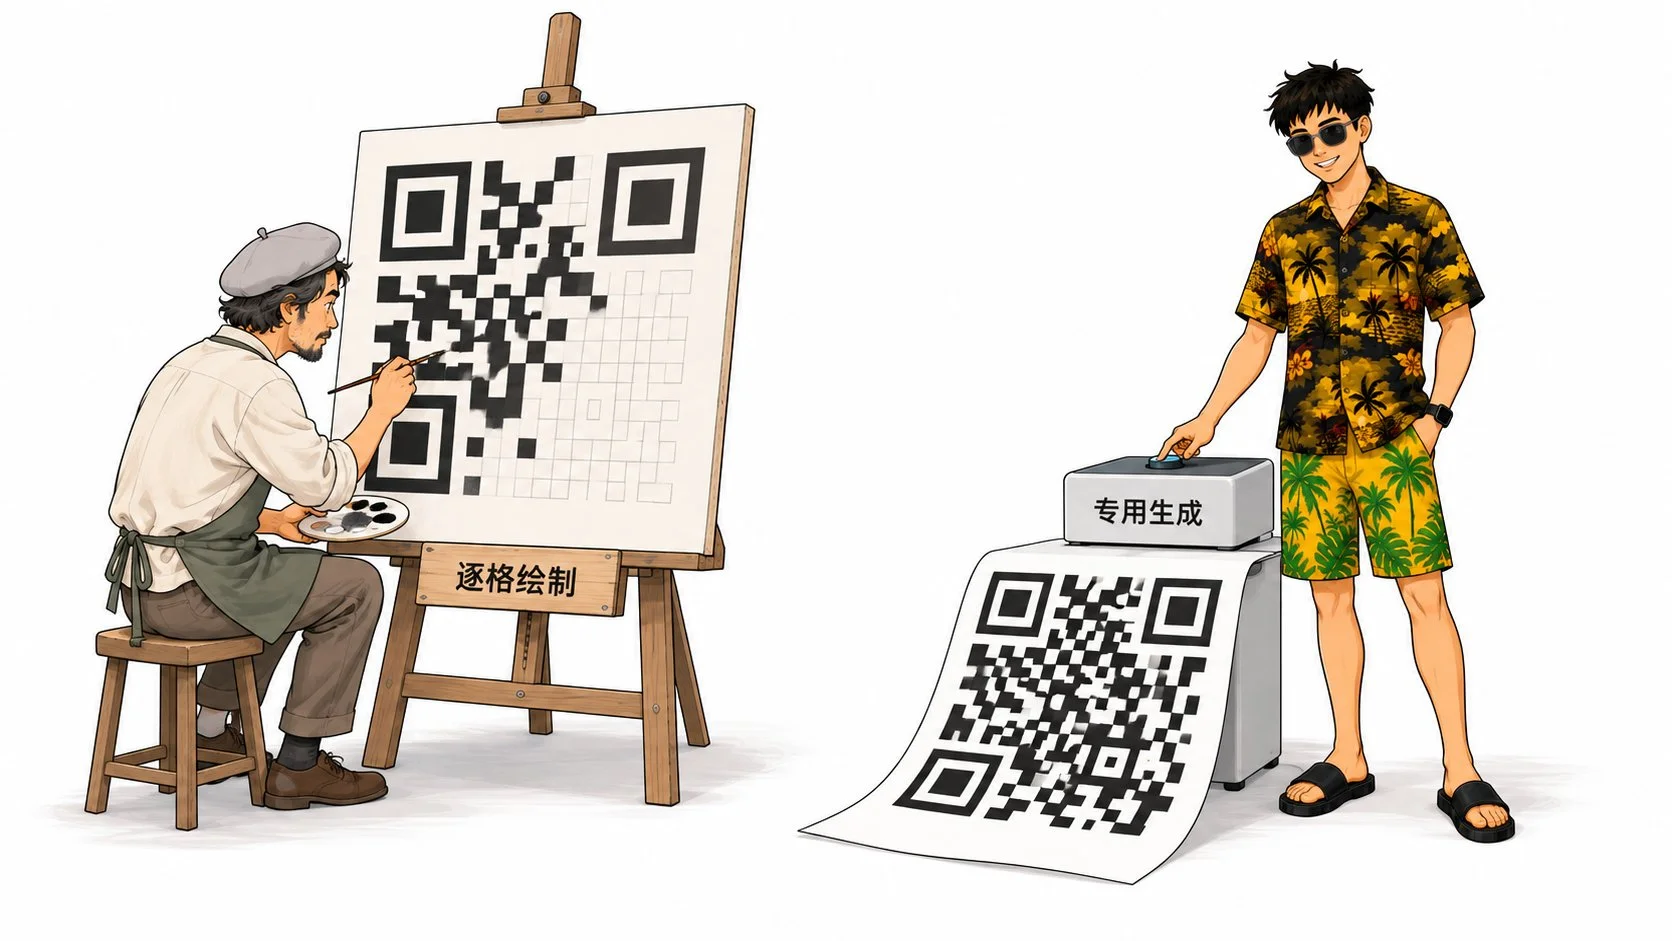
以每天处理大量电商评论为例,程序需要判断用户的态度、紧急程度和后续处理方式。如果直接调用通用大模型,不仅每次生成结构化数据的耗时较长、产生较高的调用费用,而且其逐个 token 生成的机制在面对简单的分类选择任务时显得过于“大材小用”。就好比用一位能画出精美风景画的大画家去一格一格画二维码,虽然能完成任务,但既浪费时间又增加了不必要的开销。
正是在这种背景下,TypeSafe AI 提出了 System One Models 的概念,并推出了首款公开模型 —— Jev。它专门围绕软件里的判断任务来设计,将自由生成文字的能力放下,专注于答案范围明确的快速判断,从而为软件开发和 Agent 系统提供更轻量、更经济的底层支撑。
二、Jev 模型的核心架构与传统大语言模型有何本质区别?
【核心结论】Jev 与传统大语言模型(LLM)的核心区别不在于最终是否能输出结构化数据(如 JSON),而在于模型生成结果的底层输出方式及其对判断任务的专用优化。
【解释依据】传统生成式大语言模型通常需要逐个 token 逐步生成答案,哪怕要求其输出固定格式的数据也需要经历完整的生成周期。而 Jev 针对判断任务采用了专门的输出方式,能够并行给出多项判断及其概率,在一次请求中同时处理多个问题。
【场景化建议】在需要频繁调用 AI 进行逻辑分支选择的自动化软件或 Agent 系统中,应当使用 Jev 替代通用大模型来处理分类、打分等前置判断任务,从而大幅降低系统的响应延迟和调用费用。
三、如何通过 Choice、Score 和 Noul 三大新特性精准处理结构化语义任务?
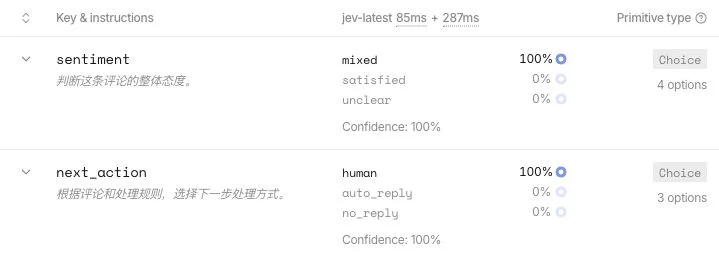
Jev 带来了三个核心特性:Choice(选择)、Score(打分)和 Noul(判断陈述成立的概率)。以下通过具体的操作细节与防坑指南来展示其应用方式。
1. Choice:做选择(通过预设选项实现多维度状态分类)
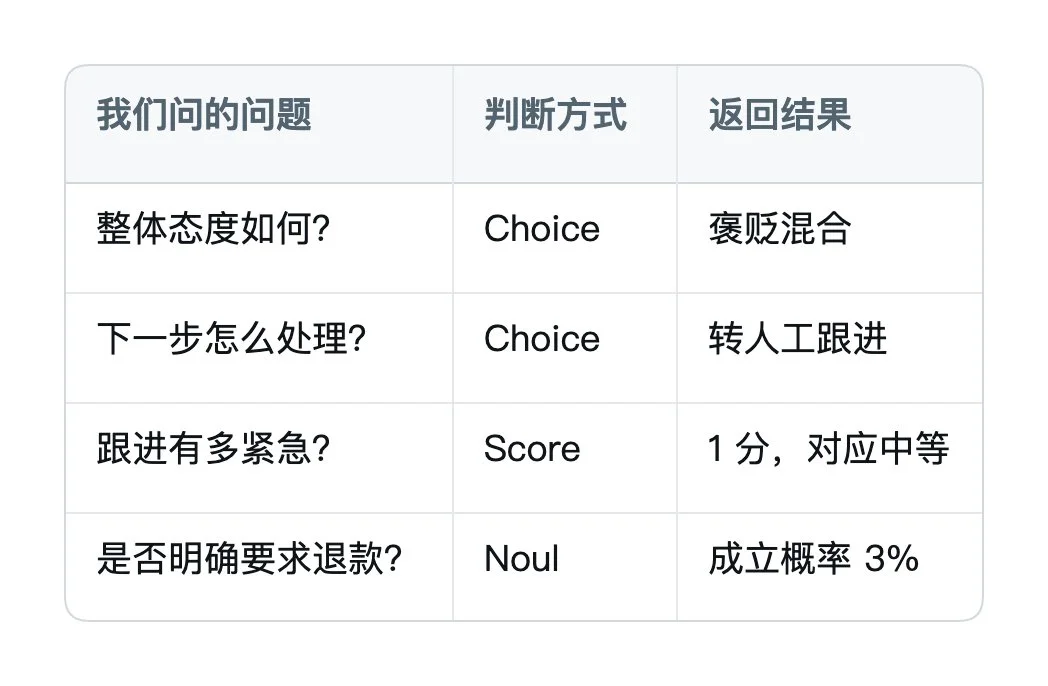
(防范分类标签遗漏的关键操作)在处理如“东西挺好,就是快递等了十天,问客服也没人回。”这样的评论时,不能仅局限于“满意”或“不满意”的二元对立。通过设定“满意、不满意、褒贬混合、无法判断”四个候选选项,Jev 能够精准识别出“褒贬混合”的态度;同时配合处理规则(如涉及未解决服务投诉需转人工),可以直接选出“转人工跟进”。
2. Score:打分(依据明确标准输出量化评估结果)
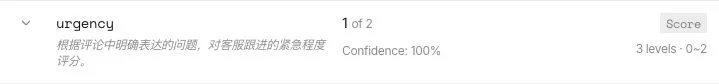
(防范评分标准模糊导致结果失真的核心技术细节)在进行紧急程度打分时,必须事先向模型明确定义各分值的边界条件。例如设定 0 分为普通咨询,1 分为未解决的物流或服务投诉,2 分为安全问题或重大损失。在输入标准后,Jev 能够针对上述电商评论返回 1 分(中等紧急程度),甚至支持落在两个等级之间的精确分值输出。
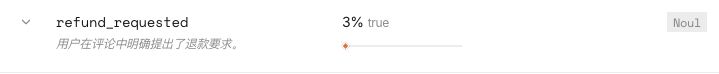
3. Noul:判断陈述成立的概率(规避关键词硬匹配的语境污染)
(防范因讽刺或复杂语境导致误判的高级技巧)当输入陈述“用户在评论中明确提出了退款要求”时,Noul 会返回一个 0 到 1 之间的概率值。对于表面夸奖实则讽刺或未提及退款的评论,模型会给出极低的概率(例如 3%),从而有效避免了传统关键词匹配工具容易忽略语境的弊端。
四、如何将 Jev 嵌入现有软件工作流与 AI Agent 系统?
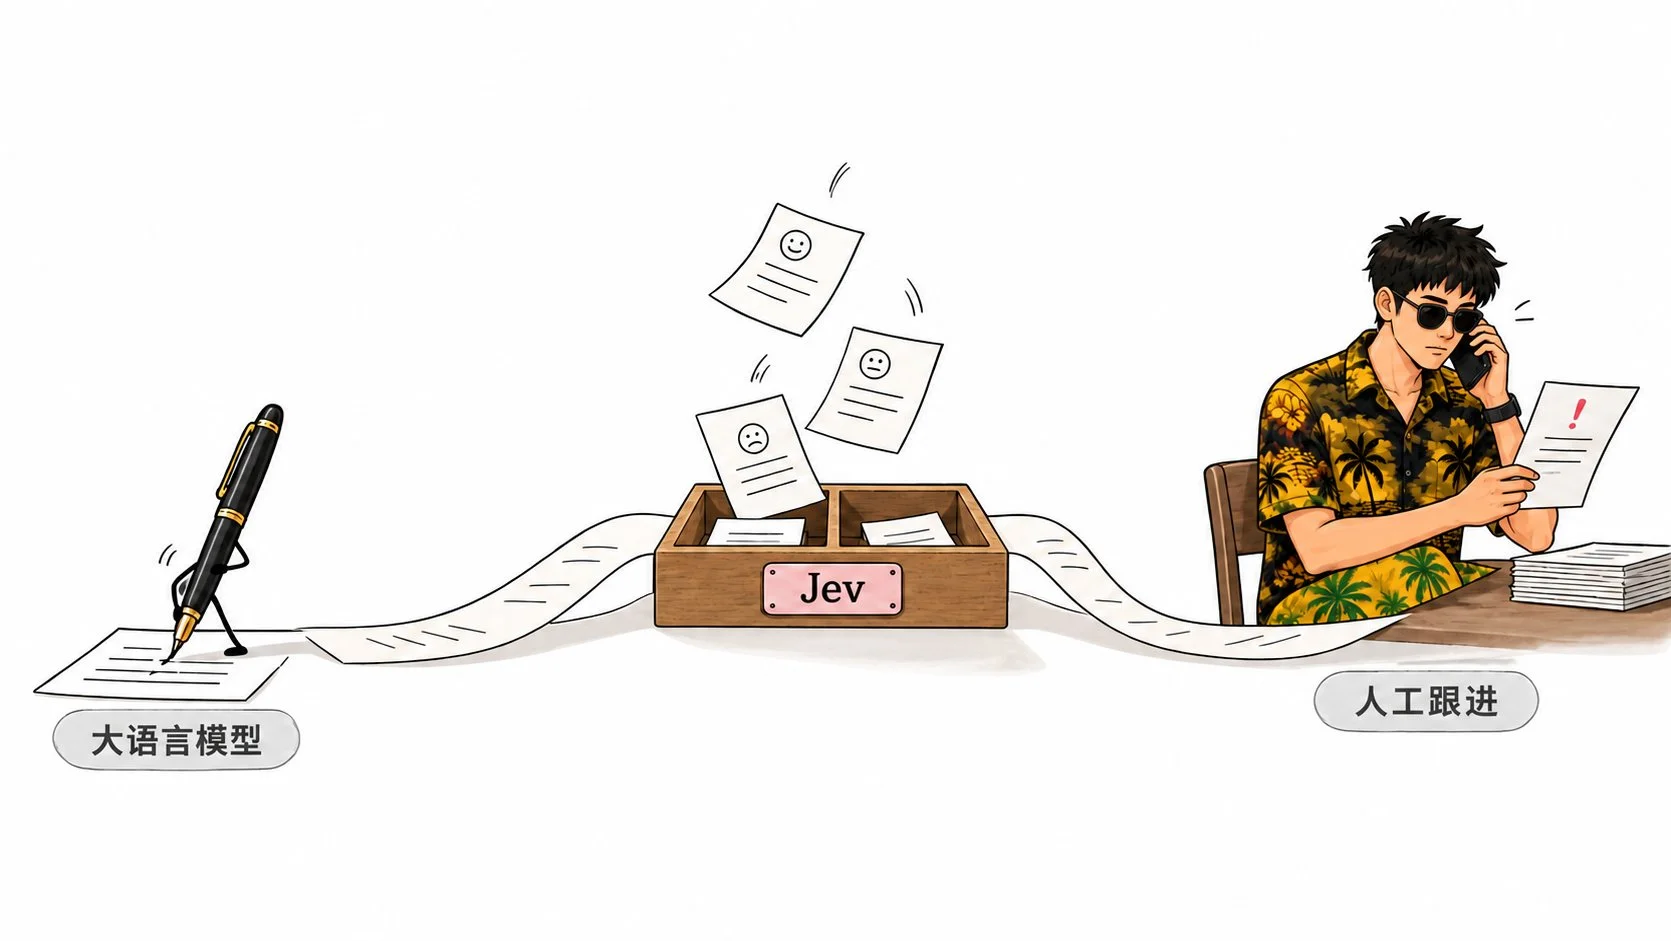
【核心结论】Jev 不能孤立存在,它需要与外部程序(Harness 壳工程)及通用大模型形成有机协作,共同构成完整的自动化处理流水线。
【解释依据】在一个复杂的处理系统中,Jev 专门负责前置的快速判断、分类与打分(大约 85 毫秒的评估时间)。一旦获取了“转人工”或“自动回复”等判断结果,外部程序即可根据规则进行分流:无需回应的直接归档,需要深入生成内容的则交由大语言模型(LLM)结合背景信息撰写回复。
【场景化建议】开发者可以通过 TypeSafe Playground 进行在线测试,或者通过官方 API Key 与 SDK 将 Jev 接入自己的软件。在价格方面,其输入成本为每百万 token 0.042 美元(输出免费),非常适合处理海量高频的结构化判断任务。
五、Jev 模型 vs 通用大语言模型:在自动化软件判断场景下的选择与取舍
| 对比维度 | Jev 模型 (System One) | 通用大语言模型 (LLM) |
|---|---|---|
| 核心设计目标 | 专门围绕软件里的判断、选择、打分任务设计 | 侧重于文字、代码生成及复杂多步推理 |
| 输出方式 | 并行输出多项判断及其概率,选项范围明确 | 逐个 token 自由生成文本或结构化数据 |
| 响应速度 | 极快(单次评估约 85 毫秒) | 相对较慢(受限于生成式 Token 长度) |
| 调用成本 | 极低(百万输入 token 仅需 0.042 美元) | 较高 |
| 最佳应用场景 | AI Agent 前置筛选、海量评论分类、逻辑分支判断 | 文案创作、复杂推理、多步工具调用 |
常见问题 (FAQ)
Jev 模型可以完全替代现有的通用大语言模型吗?
不可以。Jev 与大语言模型是互补关系而非互斥关系。Jev 专注于速度快、成本低的判断、选择和打分任务;而当系统需要进行复杂的长文本生成、代码编写或多步推理时,仍然需要依赖通用大语言模型。
Jev 的 API 计费方式是怎样的?
根据官方公布的信息,Jev 采用按调用量计费的模式,输入价格为每百万 token 0.042 美元,输出部分则为免费。输入内容包括待判断的材料、问题以及设定的判断标准。
七、结论
Jev 模型的出现填补了 AI 在结构化数据处理与概率判断赛道上的空白。它通过针对判断任务的架构优化,实现了约 85 毫秒的极速响应与极低的调用成本,为 AI Agent 和自动化软件开发提供了全新的解题思路。未来,随着各类专用模型的不断演进,将快速判断与复杂思考有机结合的多模型协作架构,必将成为软件智能化转型的重要发展方向。
暂无评论内容