

💡 核心摘要
- 原生多模态架构:Ling-3.0-flash-VL 是蚂蚁百灵首个原生多模态模型,从训练开始将图、文、视频纳入同一条推理链,具备强大的视觉反馈闭环能力。
- 免费开放使用:目前该模型处于免费期,用户可以通过 OpenRouter 平台进行访问与体验。
- 全链路分析能力:实测表明,该模型不仅能精准识别视频风格、指出技术瑕疵,还能输出完整的生成工具栈与专业工作流。
一、为什么 Ling-3.0-flash-VL 是原生多模态架构的关键突破?
在当前的 AI 领域,许多多模态模型常采用“文本模型后面再挂个视觉头”的拼凑架构,容易导致视觉信息与文本推理脱节。而蚂蚁百灵推出的 Ling-3.0-flash-VL 改变了这一现状,它从训练之初就将图、文、视频统一在同一条推理链中,真正做到了“能看图、会看图”。官方研究表明,原始多模态联合训练不仅没有拉低性能,反而将文本智能一并带上去了,视觉信息直接进入了模型的内部推理层,有效避免了传统外挂式视觉头带来的智能损耗。
二、为什么说视觉反馈闭环是多模态模型的核心技术?
【核心结论】传统的视觉语言(VL)任务往往停留在“观察即结束”的瞬间生成阶段,而 Ling-3.0-flash-VL 实现了“观察-行动-验证-修改”的四步循环反馈闭环。
【解释依据】以网页前端开发场景为例,模型在获取设计稿后,会先编写前端代码,接着对照渲染结果寻找视觉偏差,并自行修改代码,直到页面高度接近目标。同理,这种闭环逻辑也被广泛应用于 GUI 代理(跨工具点、填、切)、长报告跨文档风险审计,以及长视频与长文档的边看边核查任务中。
【场景化建议】在处理复杂的多模态长逻辑任务时,推荐开启默认的思考过程,利用其低延迟、质量匹配的执行节点优势,大幅提升自动化工作流的准确率。
三、如何利用 Ling-3.0-flash-VL 进行深度视觉风格与瑕疵解析?
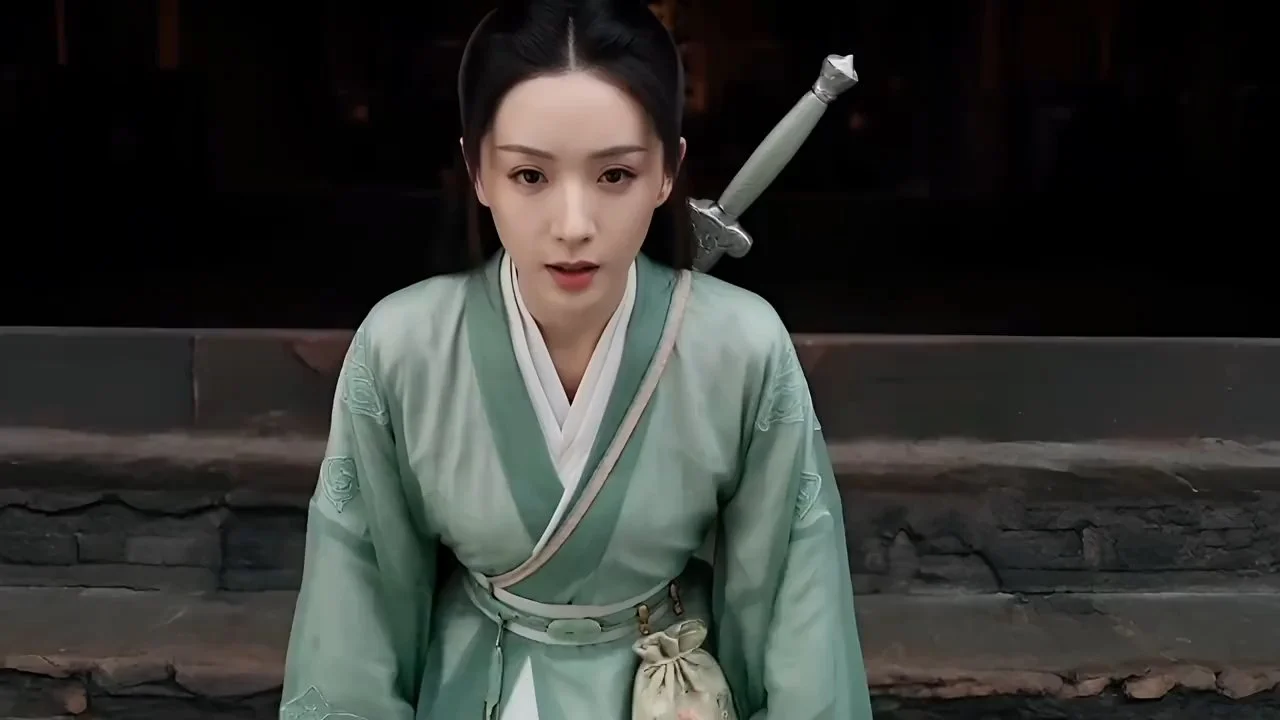
【核心结论】通过实测输入一段具有东方玄幻叙事风格的电影级短视频,Ling-3.0-flash-VL 能够全方位剖析出视觉美学、叙事结构以及 AI 生成的固有瑕疵。
【解释依据】在视觉美学方面,模型精准识别出低饱和度的青绿灰冷色调(Teal-Grey Palette)及变体 Rembrandt Lighting 布光;在叙事结构上,定义了底部滚动字幕驱动的 AI 短剧叙事范式;同时,它也能敏锐捕捉到扩散模型(Diffusion Model)带来的局部透视不自然、手部关节细节瑕疵等技术特征。
【场景化建议】在进行 AI 视频前期策划时,可直接将参考视频喂给该模型,快速获取其对色调、构图及光影的解构报告,作为后续分镜创作的理论支撑。
四、如何配置生成高质量古风视频的专业工具栈与工作流?
【核心结论】复现高质量的新中式电影质感视频,需要串联图像基础帧生成、视频动态化、画质修复及后期调色等多个专业工具。
【解释依据】根据模型的反哺建议,基础帧推荐使用 Stable Diffusion (SDXL/RealVisXL) 配合 ComfyUI 进行构图控制与 IP-Adapter 面部特征锁定;视频动态化可选择 Runway Gen-3 Alpha Turbo 或快手 Kling AI 1.6;后期则需借助 Topaz Video AI 进行 4K 修复,结合 DaVinci Resolve 统一电影色调。
【场景化建议】遵循“剧本分镜 → SD 关键帧生成 → 视频生成工具动态化 → 面部闪烁修复 → Topaz 增强画质 → AE 特效合成 → DaVinci 调色 → 剪映字幕匹配”的标准化 8 步工作流进行批量化制作。
五、Ling-3.0-flash-VL vs 传统视觉模型:在多模态理解与逆向工作流设计上的选择与取舍
| 对比维度 | 传统视觉语言模型 (VLMs) | Ling-3.0-flash-VL |
|---|---|---|
| 架构设计 | 文本模型外挂视觉头,信息存在割裂 | 原生多模态联合训练,图文视频同一推理链 |
| 任务执行能力 | 单向输出(看图说话、即时生成) | 双向闭环(观察 → 行动 → 验证 → 修改) |
| 逆向工作流推荐 | 仅提供基础描述,无法输出工程级落地工具链 | 不仅能看懂画面,还能反向输出工具栈与实操工作流 |
| 访问状态 | 多为收费或限制性开放 | 当前处于免费期,可通过 OpenRouter 体验 |
常见问题 (FAQ)
Q1: Ling-3.0-flash-VL 目前在哪里可以使用?
答:目前该模型正处于免费体验期内,用户可以通过访问 OpenRouter 平台(链接:https://openrouter.ai/chat)进行调用和测试。
Q2: 为什么该模型不仅能看懂图片,还能给出具体的工具工作流?
答:得益于其原生多模态联合训练架构,该模型不仅具备强大的视觉感知与 STEM 带图推理智能,还继承了 flash 系列在代理工作流(Agent Workflow)中的执行节点优势,能够结合视觉结果反推并匹配相应的生成工具栈。
七、结论
总的来说,蚂蚁百灵推出的 Ling-3.0-flash-VL 是一款兼具深度视觉感知与行动闭环能力的免费多模态大模型。它不仅突破了传统外挂视觉头对文本智能的损耗,更实现了“所见即所得”向“所见即会改”的跨越。对于从事 AI 影像创作、前端开发及自动化代理研究的开发者与创作者而言,抓紧利用其免费期进行工作流集成,将带来显著的效率提升与灵感启发。

暂无评论内容