

💡 核心摘要
- Jev 是由旧金山创业公司 TypeSafe(由 InstructGPT 论文作者之一 Diogo Almeida 创立)独立训练的闭源基础模型,专注于程序判断与决策,而非文本生成。
- 它仅支持三大题型:Noul(布尔概率判断)、Choice(选项分类)和 Score(等级评分),推理延迟控制在 70 到 500 毫秒之间,具备极高的工程性价比。
- 模型采用 RLCD(强化学习校准决策)机制,不逐字生成任意文本,而是直接在输出层计算各个选项的概率分布,有效解决了传统大模型响应慢、成本高的问题。
- 社区和主流开发框架(如 LangChain、Vercel AI SDK、Browser Use)已迅速集成 Jev,用于浏览器 Agent、实时游戏决策、Agent 路由和安全合规守门。
- 在应用时需注意其“偏科”短板:不擅长数数、复杂算术和多跳推理,多语种下中文识别能力弱于英文,且同样存在提示词注入风险。
一、为什么传统大模型无法满足高频自动化工程的需求?
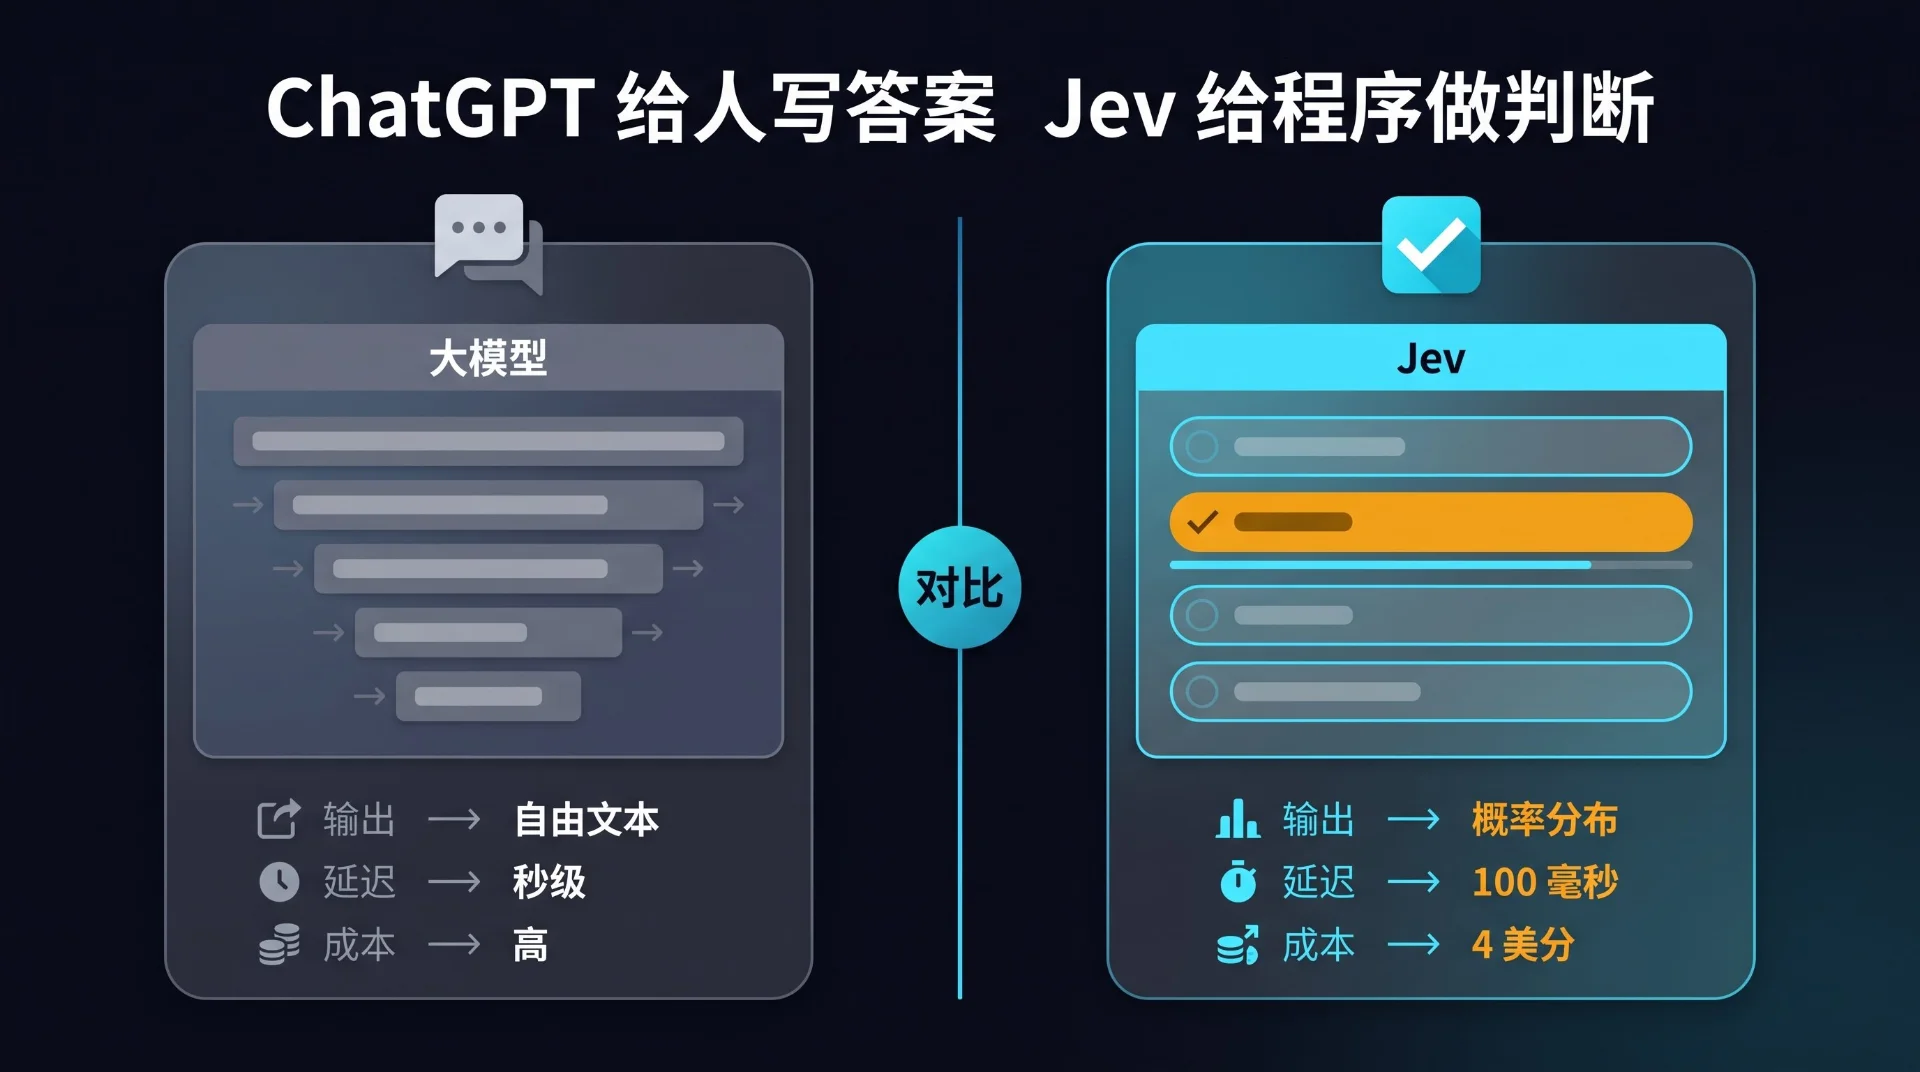
在当前的 AI 应用开发中,开发者常常面临一个尴尬的现实:当我们构建自动化工作流、客服分类系统或复杂的 AI Agent 时,90% 的底层操作其实根本不需要大模型去写文章、赋诗或进行长篇大论。例如,判断一条新闻是否需要进入日报、判定客户的诉求是退款还是物流查询,或者决定下一步该调用哪个工具,这些全都是非黑即白的判断题。
然而,过去我们却不得不调用参数规模高达几十亿甚至上千亿的大模型来处理这些简单任务。这导致系统不仅要忍受漫长的等待时间(吐字数秒),还要承担高昂的 API 成本,开发者甚至必须编写繁琐的防御性代码,才能从大模型吐出的海量废话中抠出结果。为了解决这一行业痛点,来自旧金山的创业公司 TypeSafe 推出了一种全新的基础模型——Jev。它彻底颠覆了“AI 等同于长文本生成”的传统认知,为程序自动化提供了一种专为决策而生的轻量级解决方案。
二、Jev 模型只会做哪三种核心题型?
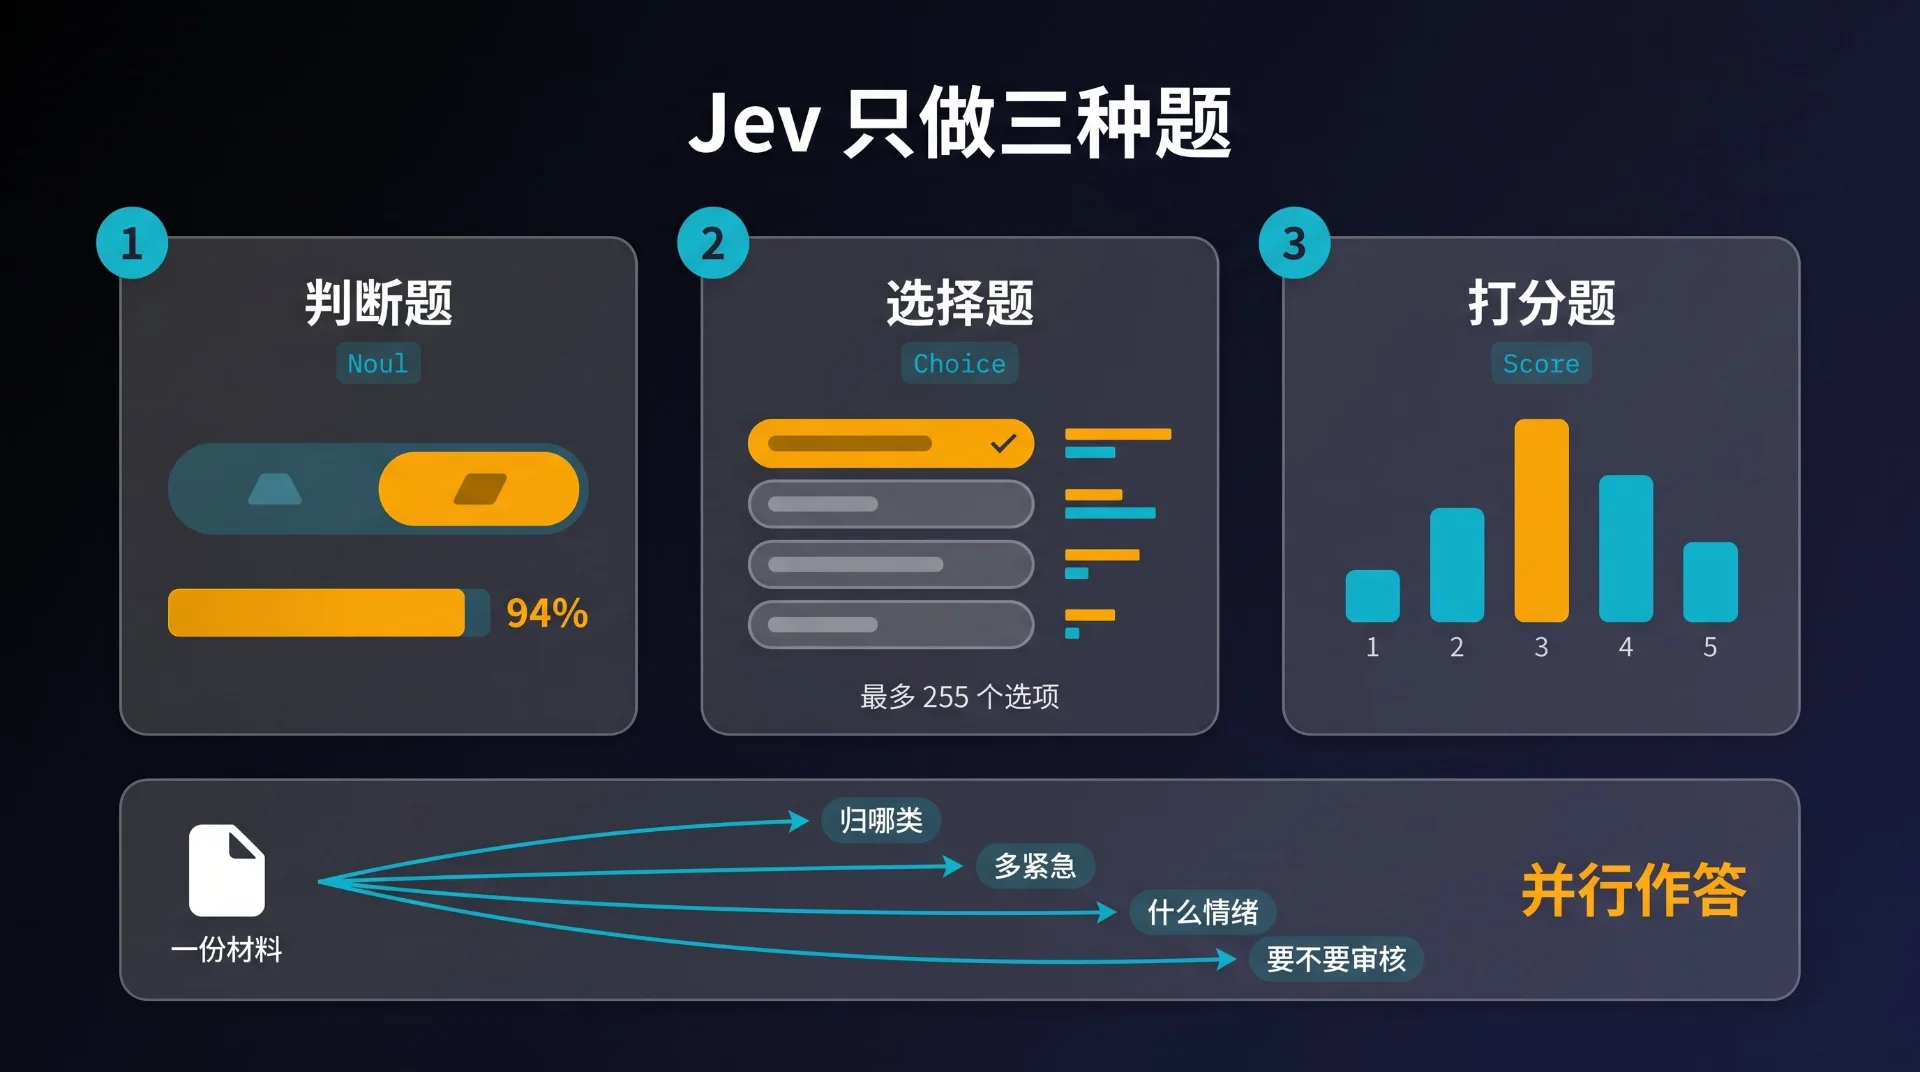
Jev 并不具备自由文本生成的接口,它更像是一个极速答题机,在代码架构中充当智能化的 if 语句。具体而言,它只接受并处理以下三类标准题型:
第一步:Noul 布尔概率判定(防范格式污染与大幅提升布尔判断效率的关键操作)
你只需要给它一段文本和一个命题(例如“这段用户留言是不是在骂客服?”),Jev 不会解释前因后果,而是直接返回一个布尔概率(例如判定为真的概率是 94%)。开发者的代码拿到这个数字后,只需设定一个大于 80% 的阈值,就能直接触发拦截或放行流程,彻底告别了传统 JSON 解析失败的烦恼。
第二步:Choice 选项概率分类(锁定输出空间避免幻觉的核心技术细节)
开发者可以预先设定好最多 255 个选项(例如工单处理分类:账单问题、物流延迟、退换货)。Jev 会返回每个选项的概率分布以及置信度评分。由于选项由开发者死死限定,模型绝不可能在输出格式中凭空编造出第四个不存在的类别,从而保证了后续 switch-case 逻辑的稳定执行。
第三步:Score 有序等级打分(实现多维度并行求值的性能优化手段)
在定义好的有序等级上进行打分(例如给客户的怒气值打 1 到 5 分),模型会返回整个分数的分布情况。更强大的是,Jev 支持“读一次材料,同时答多道题”的并行机制。输入同一张工单文本,开发者可以同时询问其归类、紧急程度、情绪和审核需求,Jev 仅需读取一次材料便能在几百毫秒内并行交卷。
三、为什么 Jev 能够实现百毫秒级的极速推理?
很多人会对“只做选择题的模型”产生质疑,认为这可能只是一种营销噱头。但如果从计算机底层架构和认知科学来看,这条技术路径完全符合工程逻辑。
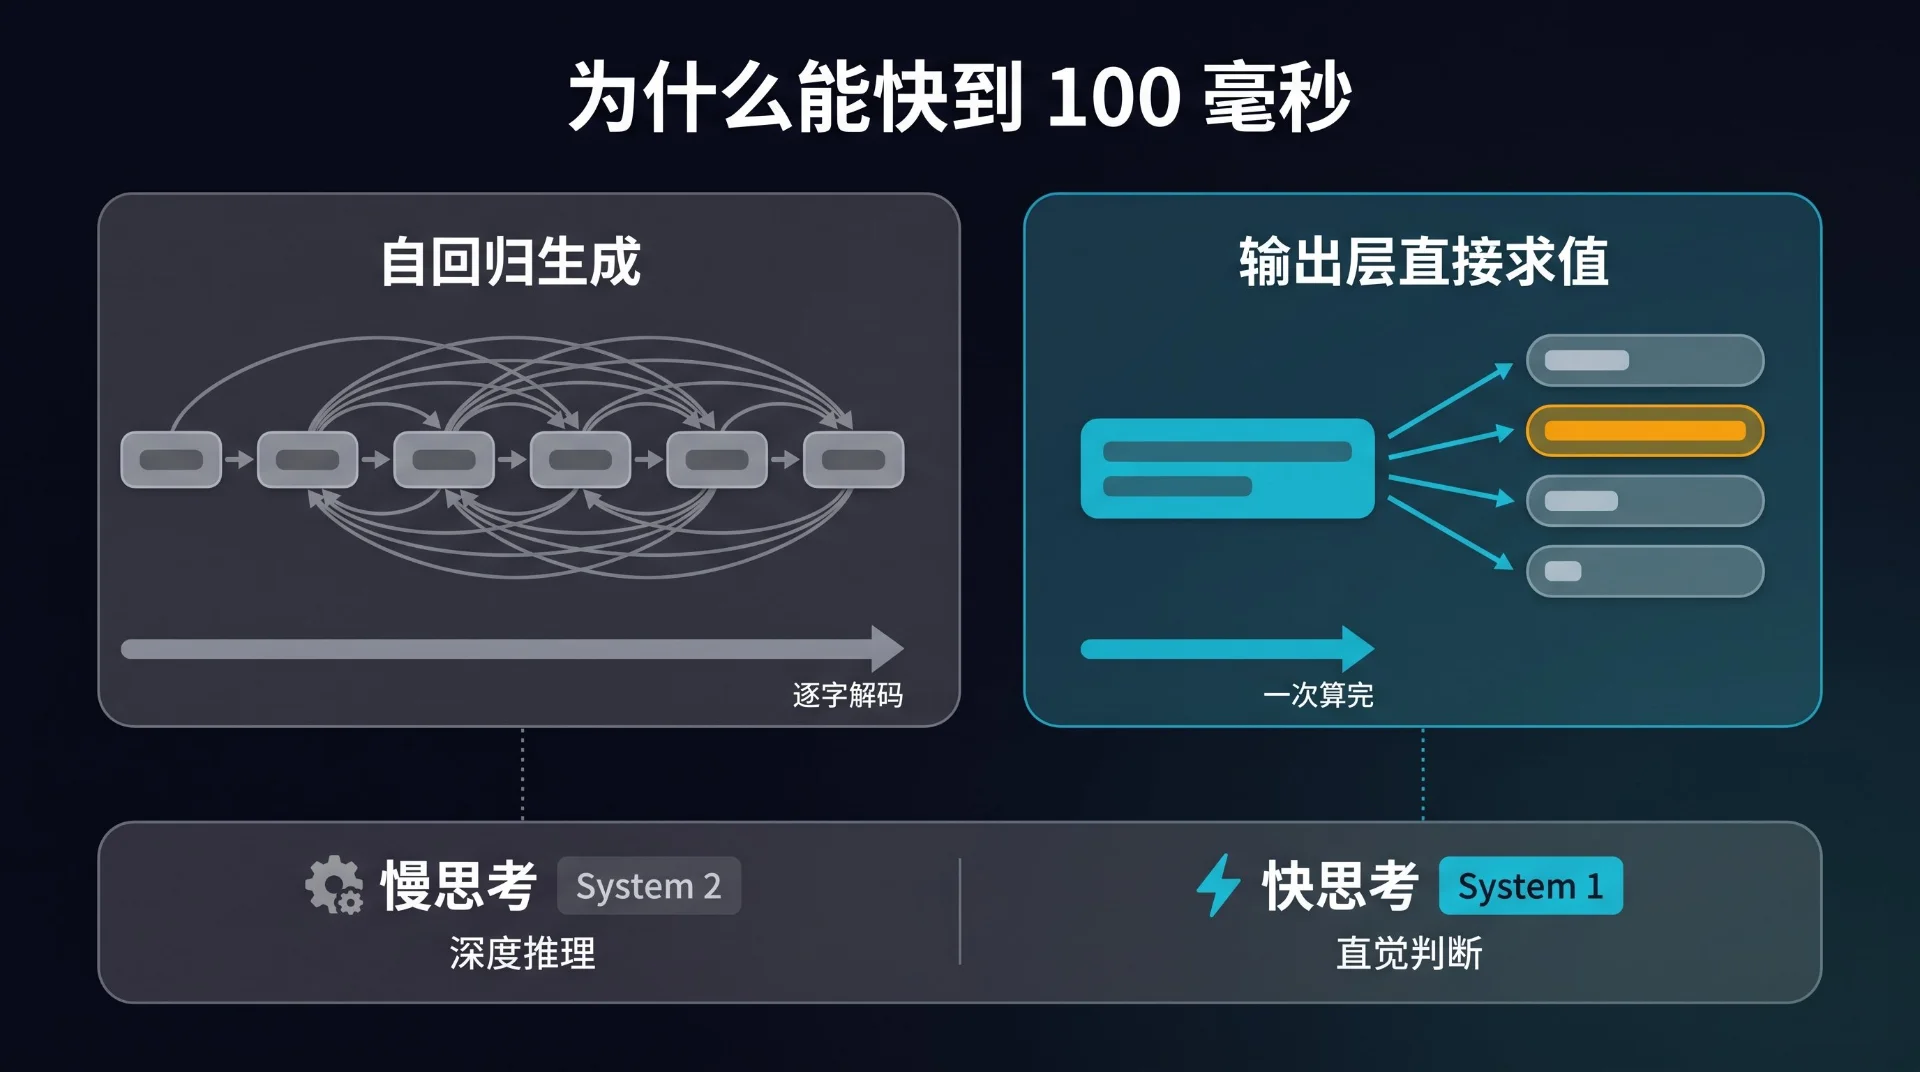
传统大模型之所以昂贵且缓慢,是因为它们采用的是逐字自回归解码(Auto-regressive decoding)机制。模型每吐出一个字,都要把前面的全部内容在注意力机制里重新计算一遍,就像一个人写作文每写一个词都要停下来琢磨下一个。这种机制赋予了大模型极强的创作能力,但拿来做是非判断,无异于开着重型卡车去路口买一瓶水。
而 Jev 的逻辑完全反其道而行之。它不生成任意文本,而是将输出空间死死限制在开发者给定的槽位里。由于不需要逐字解码,它直接在模型的输出层一次性计算各个选项的概率分布,推理时间得以压缩至 70 到 500 毫秒之间。此外,官方采用的 RLCD(强化学习校准决策)训练方法,让模型具备了可靠的置信度校准能力——当它给出 80% 把握时,统计上一百次中确实大致有 80 次正确,从而让工程师能够在代码中放心写出策略分流,例如高置信度自动放行、低置信度交由人工复查。正如诺贝尔奖得主丹尼尔·卡尼曼在《思考,快与慢》中提出的 System 1(快思考)与 System 2(慢思考)理论,大模型过去一直在模仿耗能极高的慢思考,而 Jev 则是在为 AI 补齐那个高速、轻量、只凭直觉做判断的 System 1。
四、开发者目前如何将 Jev 应用于主流开发框架与真实场景?
在社区生态中,Jev 刚发布便被各大开源项目和基础设施火速集成,落地场景远超简单的文本分类:
第一步:极速浏览器 Agent 改造(降低 DOM 解析延迟的实战方案)
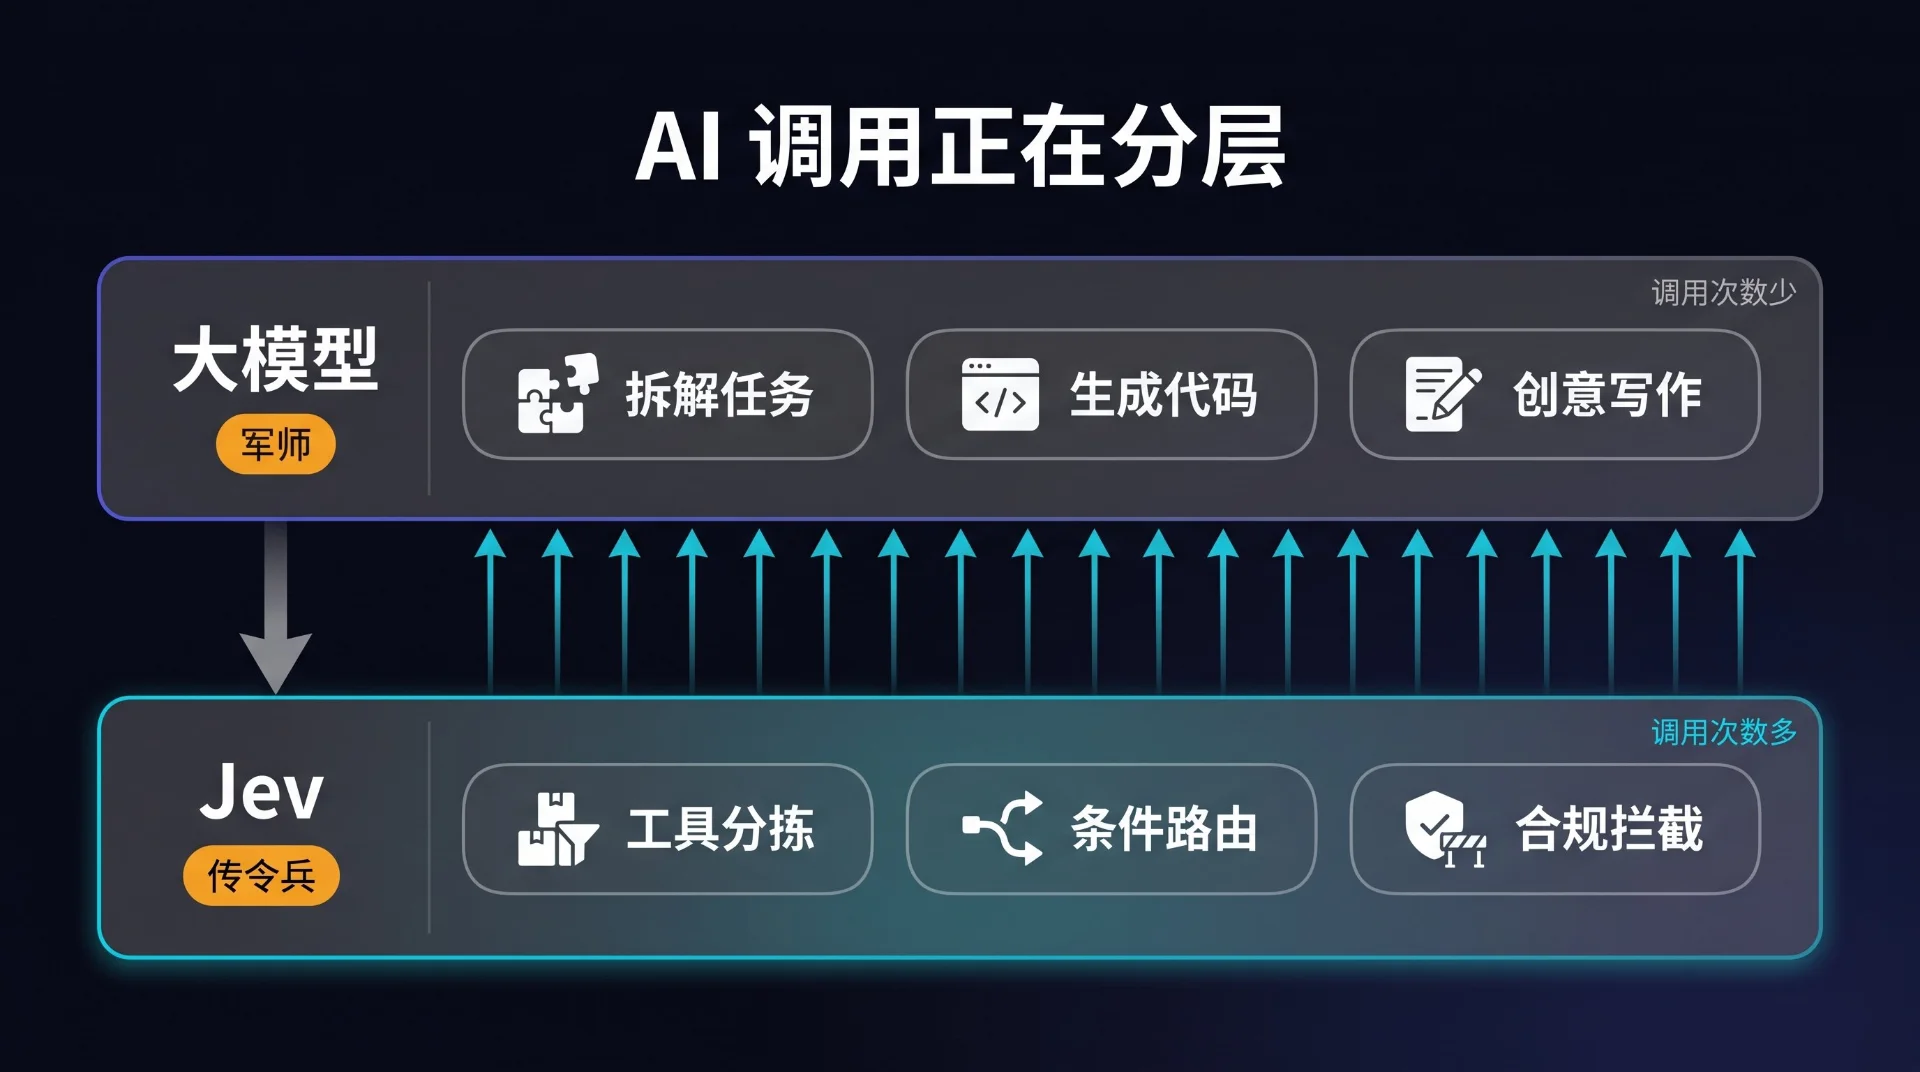
Browser Use 社区开源了 Jev Ultrafast 浏览器 Agent。它将网页操作拆分为两层:Jev 专门负责单选和页面元素点击决策,几十毫秒就能决定下一步操作;只有在需要输入复杂搜索词时才调用小型文本生成模型。实测显示,其完成跨城市航班搜索的全流程仅需 7.1 秒。
第二步:实时游戏与高频决策流集成(LangChain 与 Vercel AI SDK 的接入实践)
LangChain 推出了 TypeSafeClassifier,利用 Jev 在复杂的 Multi-Agent 架构中做极速路由,消除了控制流判断的等待时间;Vercel AI Gateway 也在 AI SDK 7 的 evaluate 函数中做了集成,开发者可将其作为实时安全守门员与输出裁判,在几十毫秒内完成合规审核,避免了反复调用 GPT-4o 的高昂开销。
五、传统大模型 vs Jev 模型:在 AI 自动化工程场景下的选择与取舍
| 对比维度 | 传统大模型(如 ChatGPT / Claude) | Jev 决策基础模型 |
|---|---|---|
| 核心能力 | 自由文本生成、长文写作、代码编写、复杂多跳推理 | 结构化判断、布尔概率判定、选项分类、等级评分 |
| 输出机制 | 逐字自回归解码(System 2 慢思考) | 输出层一次性计算概率分布(System 1 快思考) |
| 推理延迟 | 数秒至数十秒 | 70 毫秒至 500 毫秒 |
| 成本与定价 | 较高,每百万 Token 成本相对昂贵 | 极低,每百万 Token 约 4 美元 |
| 典型应用场景 | 创意写作、内容生成、复杂代码重构、开放式对话 | 自动化工作流路由、客服工单分类、Agent 工具选择、实时安全审核 |
常见问题 (FAQ)
Q: Jev 模型是哪个大厂出品的?可以下载本地模型权重吗?
A: Jev 并非大厂出品,而是由旧金山创业公司 TypeSafe 独立训练的闭源基础模型。该公司由前 OpenAI 团队成员、InstructGPT 论文作者之一 Diogo Almeida 创立。目前官方仅提供云端 API,并未公开模型权重,GitHub 上的项目均为社区开发者基于其 API 编写的工具。
Q: 既然 Jev 不能写文章或聊天,它的短板和局限性有哪些?
A: 官方文档指出 Jev 存在明显的“偏科”问题:它在数数、精准算术和日期先后推算上非常不靠谱,长链条的多跳推理准确率会明显下滑;其次,模型主要针对英语训练,中文识别准确率相对较弱;此外,它同样无法完全免疫提示词注入攻击,涉及资金、退款等高风险操作时仍需底层代码进行硬权限拦截。
七、结论
Jev 模型的出现为我们带来了全新的软件工程启发:在真实的自动化流程中,计算机之间的交互并不一定每一步都需要长篇大论的自然语言。通过将大模型从沉重的造句任务中抽离出来,给系统装上一枚枚毫秒级响应的智能决策语句,开发者能够以极低的成本推动更多自动化工作流的高效运转。随着 LangChain、Vercel 等生态的不断完善,AI 调用正在向分层架构稳步演进。
暂无评论内容